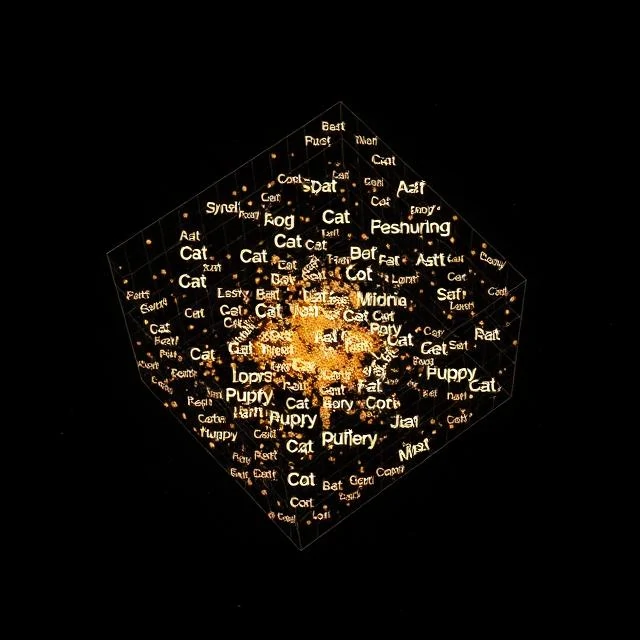
Trong một phép nhúng từ tốt, "king" trừ "man" cộng "woman" sẽ nằm gần "queen". Phép toán đó hoạt động vì các vectơ mã hóa ý nghĩa, chứ không chỉ là chính tả. Mỗi từ trở thành một danh sách dày đặc các con số, thường từ 100 đến 300 chiều, được sắp xếp sao cho các từ tương tự nằm gần nhau trong không gian vectơ.
Các cách biểu diễn cũ coi từ ngữ như những ký hiệu riêng lẻ. Một vectơ one-hot cho từ "cat" không nói lên điều gì về từ "kitten". Các embedding đã thay đổi điều đó bằng cách huấn luyện trên các kho ngữ liệu văn bản lớn: những từ xuất hiện trong các ngữ cảnh tương tự sẽ có các vectơ tương tự. Giả thuyết phân bố, đại khái là "bạn sẽ hiểu một từ qua những từ xuất hiện cùng với nó", là động lực đằng sau toàn bộ ý tưởng này.
Các phương pháp phổ biến
- Word2Vec, công cụ dự đoán từ dựa trên các từ lân cận hoặc ngược lại.
- GloVe, một công cụ phân tích ma trận đồng xuất hiện toàn cầu.
- FastText, biểu diễn các từ dưới dạng các tập hợp n-gram ký tự.
- Các nhúng ngữ cảnh từ BERT và các mô hình tương tự, trong đó vectơ của một từ phụ thuộc vào câu của nó.
Các mô hình nhúng tĩnh như Word2Vec gán một vectơ cho mỗi từ, vì vậy từ "bank" có cùng cách biểu diễn trong "river bank" và "bank account". Các mô hình ngữ cảnh khắc phục sự mơ hồ đó, đó là lý do tại sao chúng hiện đang chiếm ưu thế. Nhược điểm là chi phí: việc tính toán một vectơ ngữ cảnh yêu cầu phải chạy toàn bộ mô hình.
Comments
No comments yet. Be the first to share a thought.
Leave a comment