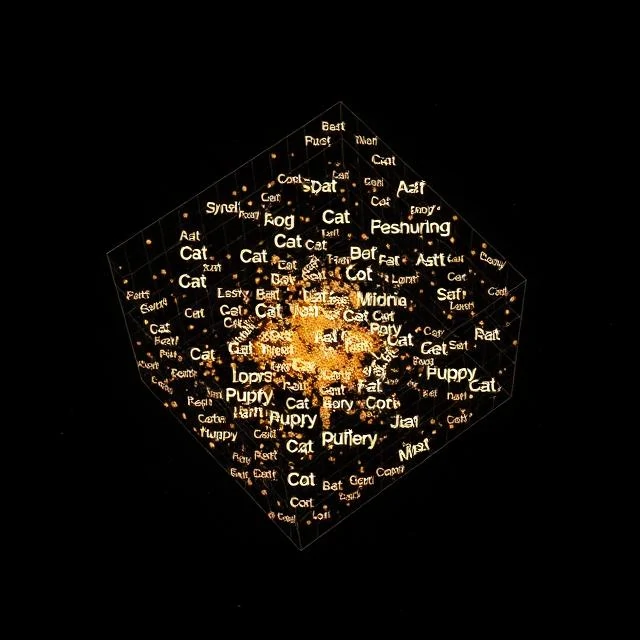
I en bra ordinbäddning landar "kung" minus "man" plus "kvinna" nära "drottning". Den aritmetiken fungerar eftersom vektorerna kodar betydelse, inte bara stavning. Varje ord blir en tät lista av tal, vanligtvis 100 till 300 dimensioner, placerade så att liknande ord sitter tätt ihop i vektorrummet.
Äldre representationer behandlade ord som isolerade symboler. En en-het vektor för "katt" sa ingenting om "kattunge". Inbäddningar ändrade detta genom att träna på stora textkorpusar: ord som förekommer i liknande sammanhang hamnar med liknande vektorer. Distributionshypotesen, ungefär "du ska känna igen ett ord genom det företag det behåller", är motorn bakom hela idén.
Populära metoder
- Word2Vec, som förutspår ett ord från dess grannar eller vice versa
- GloVe, som tar hänsyn till en global samförekomstmatris
- FastText, som representerar ord som påsar med tecken-n-gram
- Kontextuella inbäddningar från BERT och liknande modeller, där ett ords vektor beror på dess mening
Statiska inbäddningar som Word2Vec tilldelar en vektor per ord, så "bank" har samma representation i "flodbank" och "bankkonto". Kontextuella modeller åtgärdar den tvetydigheten, vilket är anledningen till att de nu dominerar. Avvägningen är kostnaden: att beräkna en kontextuell vektor kräver att hela modellen körs.
Comments
No comments yet. Be the first to share a thought.
Leave a comment