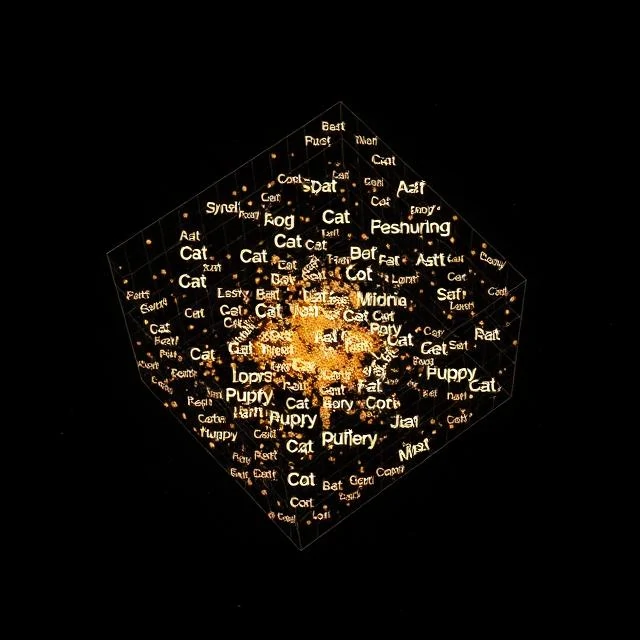
एक अच्छे शब्द संयोजन में, "राजा" में से "पुरुष" को घटाकर "महिला" को जोड़कर जो परिणाम मिलता है, वह "रानी" के पास आता है। यह गणितीय गणना इसलिए काम करती है क्योंकि सदिश केवल वर्तनी को नहीं, बल्कि अर्थ को भी समाहित करते हैं। प्रत्येक शब्द संख्याओं की एक सघन सूची बन जाता है, जिसमें आमतौर पर 100 से 300 आयाम होते हैं, और उन्हें इस प्रकार व्यवस्थित किया जाता है कि समान शब्द सदिश स्थान में एक-दूसरे के निकट स्थित हों।
पुराने स्वरूपों में शब्दों को पृथक प्रतीकों के रूप में माना जाता था। "बिल्ली" के लिए एक एकल-स्पष्ट सदिश "बिल्ली के बच्चे" के बारे में कुछ नहीं बताता था। एम्बेडिंग ने बड़े पाठ संग्रहों पर प्रशिक्षण देकर इसे बदल दिया: समान संदर्भों में आने वाले शब्दों के सदिश भी समान हो जाते हैं। वितरण संबंधी परिकल्पना, जिसका अर्थ है "आप किसी शब्द को उसके साथ आने वाले शब्दों से पहचान सकते हैं", इस संपूर्ण विचार का मूल आधार है।
लोकप्रिय विधियाँ
- Word2Vec, जो किसी शब्द के पड़ोसी शब्दों से उसका अनुमान लगाता है या इसके विपरीत।
- GloVe, जो एक वैश्विक सह-घटना मैट्रिक्स को ध्यान में रखता है
- FastText, जो शब्दों को वर्ण n-ग्राम के समूह के रूप में दर्शाता है
- BERT और इसी तरह के मॉडलों से प्राप्त प्रासंगिक एम्बेडिंग, जहाँ किसी शब्द का वेक्टर उसके वाक्य पर निर्भर करता है।
वर्ड2वेक जैसे स्टैटिक एम्बेडिंग प्रत्येक शब्द के लिए एक वेक्टर निर्दिष्ट करते हैं, इसलिए "बैंक" का प्रतिनिधित्व "नदी का किनारा" और "बैंक खाता" दोनों में समान होता है। कॉन्टेक्चुअल मॉडल इस अस्पष्टता को दूर करते हैं, यही कारण है कि वे अब अधिक प्रचलित हैं। इसका नुकसान लागत है: एक कॉन्टेक्चुअल वेक्टर की गणना के लिए पूरे मॉडल को चलाना आवश्यक होता है।
Comments
No comments yet. Be the first to share a thought.
Leave a comment