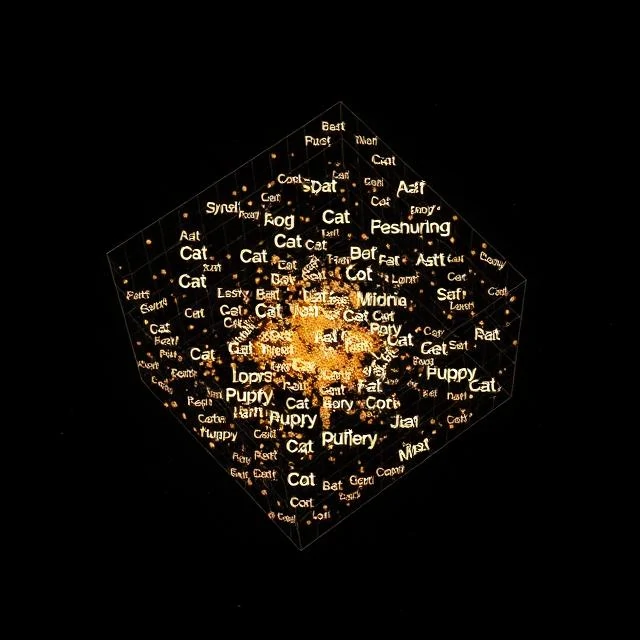
V dobrém vkládání slov se „král“ mínus „muž“ plus „žena“ nachází blízko slova „královna“. Tato aritmetika funguje, protože vektory kódují význam, nejen pravopis. Každé slovo se stává hustým seznamem čísel, obvykle o 100 až 300 dimenzích, umístěných tak, aby podobná slova byla ve vektorovém prostoru blízko sebe.
Starší reprezentace považovaly slova za izolované symboly. Jednorázový vektor pro slovo „kočka“ neříkal nic o slově „kotě“. Vkládání to změnilo trénováním na velkých textových korpusech: slova, která se objevují v podobných kontextech, končí s podobnými vektory. Motorem celé myšlenky je distribuční hypotéza, zhruba „slovo poznáte podle společnosti, ve které se nachází“.
Oblíbené metody
- Word2Vec, který předpovídá slovo od jeho sousedů a naopak
- GloVe, který zohledňuje globální matici společného výskytu
- FastText, který reprezentuje slova jako pytle znakových n-gramů
- Kontextová vkládání z BERT a podobných modelů, kde vektor slova závisí na jeho větě
Statické vkládání, jako je Word2Vec, přiřazuje jeden vektor každému slovu, takže „banka“ má stejnou reprezentaci v „říčním břehu“ a „bankovním účtu“. Kontextuální modely tuto nejednoznačnost řeší, a proto nyní dominují. Nevýhodou jsou náklady: výpočet kontextového vektoru vyžaduje spuštění celého modelu.
Comments
No comments yet. Be the first to share a thought.
Leave a comment