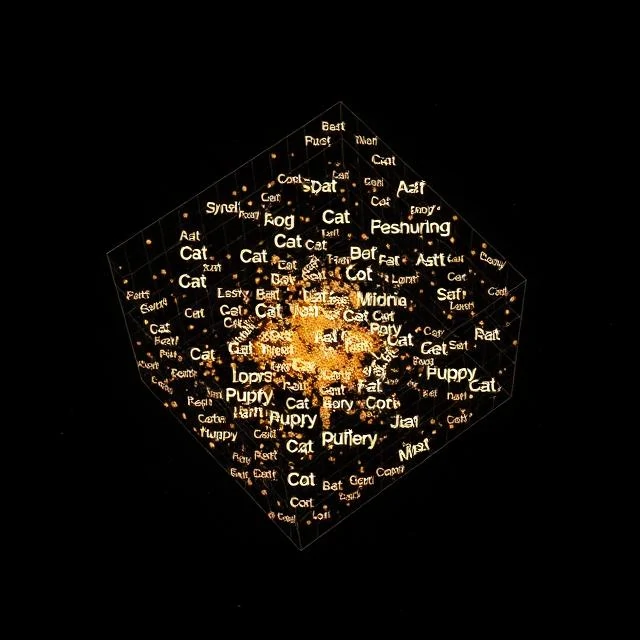
I en god ordinnlemming havner «konge» minus «mann» pluss «kvinne» nær «dronning». Denne regnestykket fungerer fordi vektorene koder for betydning, ikke bare staving. Hvert ord blir en tett liste med tall, vanligvis 100 til 300 dimensjoner, plassert slik at lignende ord sitter tett sammen i vektorrommet.
Eldre representasjoner behandlet ord som isolerte symboler. En en-hot vektor for «katt» sa ingenting om «kattunge». Innebygginger endret dette ved å trene på store tekstkorpora: ord som vises i lignende kontekster ender opp med lignende vektorer. Distribusjonshypotesen, omtrent «du skal kjenne igjen et ord ved selskapet det beholder», er motoren bak hele ideen.
Populære metoder
- Word2Vec, som forutsier et ord fra naboordet eller omvendt
- GloVe, som tar hensyn til en global samforekomstmatrise
- FastText, som representerer ord som poser med tegn-n-grammer
- Kontekstuelle innebygginger fra BERT og lignende modeller, der et ords vektor avhenger av setningen
Statiske innebygginger som Word2Vec tilordner én vektor per ord, slik at «bank» har samme representasjon i «elvebredden» og «bankkonto». Kontekstuelle modeller fikser denne tvetydigheten, og det er derfor de nå dominerer. Avveiningen er kostnad: å beregne en kontekstuell vektor krever at hele modellen kjøres.
Comments
No comments yet. Be the first to share a thought.
Leave a comment