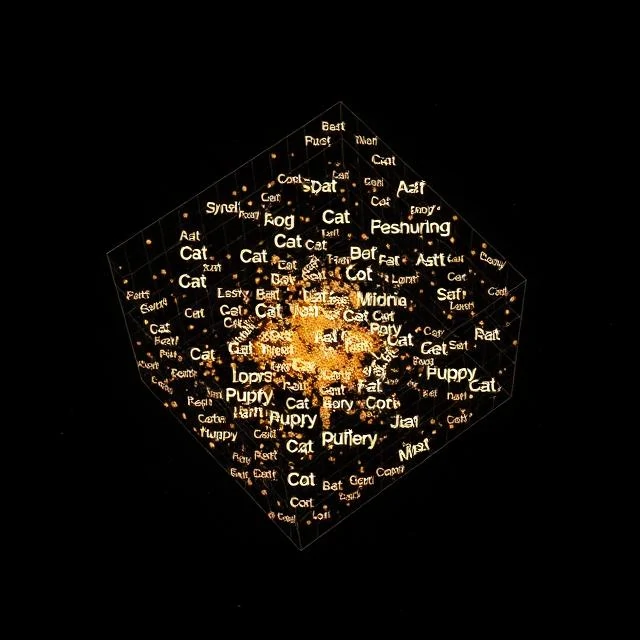
В хорошем векторном представлении слов «король» минус «мужчина» плюс «женщина» оказывается рядом со словом «королева». Эта арифметика работает, потому что векторы кодируют смысл, а не просто орфографию. Каждое слово становится плотным списком чисел, обычно от 100 до 300 измерений, расположенных таким образом, что похожие слова находятся близко друг к другу в векторном пространстве.
Более старые представления рассматривали слова как изолированные символы. Вектор one-hot для слова «кот» ничего не говорил о слове «котенок». Эмбеддинги изменили это благодаря обучению на больших текстовых корпусах: слова, встречающиеся в схожих контекстах, в итоге получают схожие векторы. Дистрибутивная гипотеза, примерно так: «слово можно узнать по тому, с кем оно общается», лежит в основе всей этой идеи.
Популярные методы
- Word2Vec — это технология, которая предсказывает слово по его соседям или наоборот.
- GloVe, который учитывает глобальную матрицу совместной встречаемости.
- FastText, который представляет слова в виде наборов n-грамм символов.
- Контекстные векторные представления из BERT и аналогичных моделей, где вектор слова зависит от предложения.
Статические векторные представления, такие как Word2Vec, присваивают каждому слову один вектор, поэтому слово «банк» имеет одинаковое представление в словах «берег реки» и «банковский счет». Контекстуальные модели устраняют эту неоднозначность, поэтому они сейчас доминируют. Компромисс заключается в стоимости: для вычисления контекстуального вектора требуется запустить всю модель.
Comments
No comments yet. Be the first to share a thought.
Leave a comment