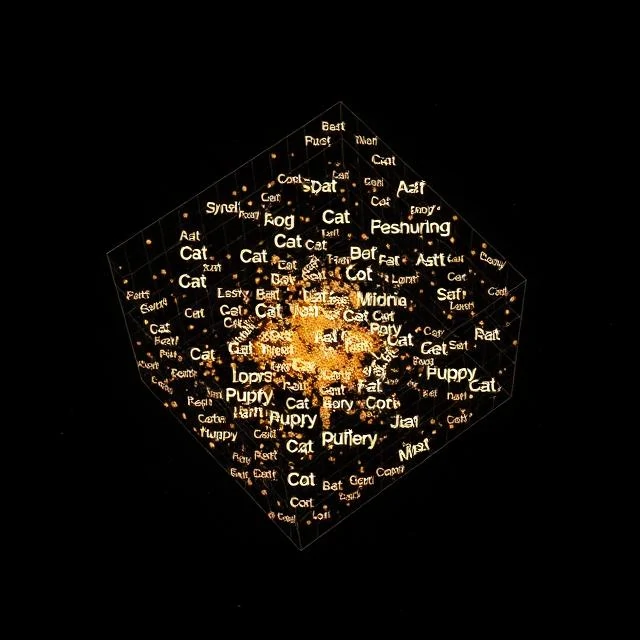
في تمثيل الكلمات الجيد، يكون ناتج طرح "ملك" من "رجل" وإضافة "امرأة" قريبًا من ناتج "ملكة". تنجح هذه العملية الحسابية لأن المتجهات تشفر المعنى، وليس مجرد التهجئة. تصبح كل كلمة قائمة كثيفة من الأرقام، عادةً ما تتراوح أبعادها بين 100 و300، مرتبة بحيث تتقارب الكلمات المتشابهة في فضاء المتجهات.
كانت التمثيلات القديمة تتعامل مع الكلمات كرموز معزولة. لم يُظهر متجه الترميز الأحادي لكلمة "قطة" أي شيء عن كلمة "هريرة". غيّرت التضمينات ذلك من خلال التدريب على مجموعات نصوص ضخمة: فالكلمات التي تظهر في سياقات متشابهة ينتهي بها المطاف بمتجهات متشابهة. الفرضية التوزيعية، التي تُعرف تقريبًا بـ "تعرف الكلمة من سياقها"، هي المحرك الأساسي لهذه الفكرة.
الطرق الشائعة
- Word2Vec، الذي يتنبأ بالكلمة من جيرانها أو العكس
- GloVe، الذي يأخذ في الاعتبار مصفوفة التواجد المشترك العالمية
- FastText، الذي يمثل الكلمات على شكل مجموعات من الأحرف n-grams
- التضمينات السياقية من BERT والنماذج المماثلة، حيث يعتمد متجه الكلمة على جملتها
تُخصص تقنيات التضمين الثابتة، مثل Word2Vec، متجهًا واحدًا لكل كلمة، لذا فإن كلمة "bank" لها نفس التمثيل في "river bank" و"bank account". تُعالج النماذج السياقية هذا الغموض، ولهذا السبب هيمنت الآن. لكنّ المقابل هو التكلفة: فحساب المتجه السياقي يتطلب تشغيل النموذج بأكمله.
Comments
No comments yet. Be the first to share a thought.
Leave a comment