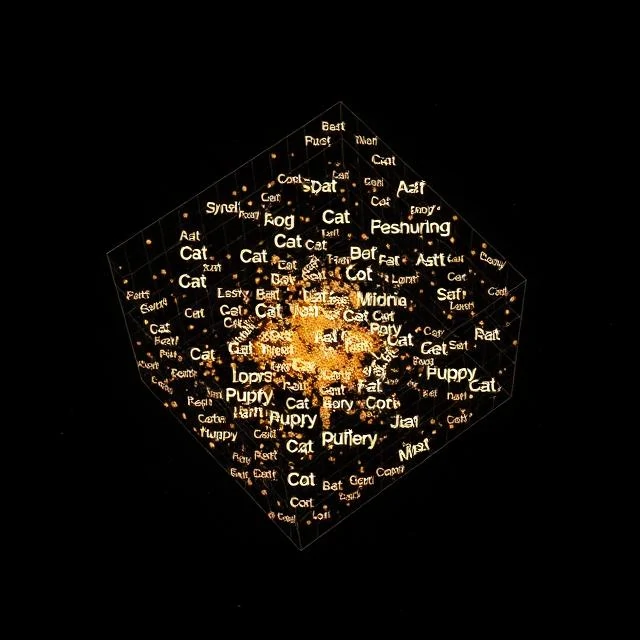
Într-o bună încorporare de cuvinte, „rege” minus „bărbat” plus „femeie” ajunge lângă „regină”. Această aritmetică funcționează deoarece vectorii codifică sensul, nu doar ortografia. Fiecare cuvânt devine o listă densă de numere, de obicei de la 100 la 300 de dimensiuni, poziționate astfel încât cuvinte similare să fie apropiate în spațiul vectorial.
Reprezentările mai vechi tratau cuvintele ca simboluri izolate. Un vector cu un singur punct de reper pentru „pisică” nu spunea nimic despre „pisoi”. Integrarea cuvintelor a schimbat acest lucru prin antrenament pe corpusuri de text mari: cuvintele care apar în contexte similare ajung să aibă vectori similari. Ipoteza distribuțională, aproximativ „vei recunoaște un cuvânt după compania pe care o are”, este motorul din spatele întregii idei.
Metode populare
- Word2Vec, care prezice un cuvânt de la vecinii săi sau invers
- GloVe, care ia în considerare o matrice globală de co-ocurență
- FastText, care reprezintă cuvintele ca niște saci de n-grame de caractere
- Încorporări contextuale din BERT și modele similare, unde vectorul unui cuvânt depinde de propoziția sa
Integrarea statică precum Word2Vec atribuie un vector per cuvânt, astfel încât „bancă” are aceeași reprezentare în „malul râului” și „cont bancar”. Modelele contextuale remediază această ambiguitate, motiv pentru care acum domină. Compromisul este costul: calcularea unui vector contextual necesită rularea întregului model.
Comments
No comments yet. Be the first to share a thought.
Leave a comment