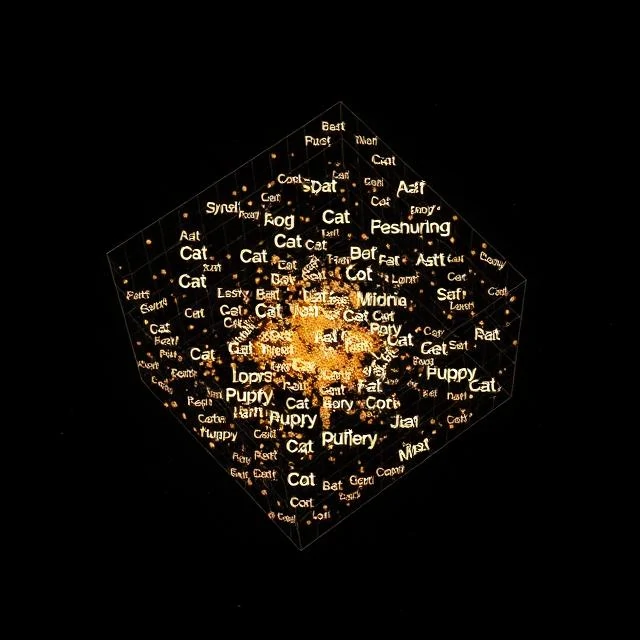
İyi bir kelime gömme işleminde, "kral" kelimesinden "adam" kelimesini çıkarıp "kadın" kelimesini eklediğimizde sonuç "kraliçe" kelimesinin yakınına düşer. Bu aritmetik işe yarar çünkü vektörler sadece yazımı değil, anlamı da kodlar. Her kelime, genellikle 100 ila 300 boyutlu, benzer kelimelerin vektör uzayında birbirine yakın konumlanacağı şekilde yerleştirilmiş yoğun bir sayı listesi haline gelir.
Eski gösterimler kelimeleri izole semboller olarak ele alıyordu. "Kedi" için tekil kodlu bir vektör "yavru kedi" hakkında hiçbir şey söylemiyordu. Gömme vektörleri, büyük metin külliyatları üzerinde eğitim yaparak bunu değiştirdi: benzer bağlamlarda görünen kelimeler benzer vektörlerle sonuçlanıyor. Kabaca "bir kelimeyi birlikte göründüğü kelimelerden tanırsınız" anlamına gelen dağılımsal hipotez, tüm fikrin arkasındaki itici güçtür.
Popüler yöntemler
- Word2Vec, komşu kelimelerden bir kelimeyi veya tam tersini tahmin eden bir araçtır.
- GloVe, küresel bir eş zamanlılık matrisini hesaba katan bir sistemdir.
- FastText, kelimeleri karakter n-gramlarından oluşan torbalar olarak temsil eder.
- BERT ve benzeri modellerden elde edilen bağlamsal gömme vektörleri, bir kelimenin vektörünün cümledeki yerine bağlı olduğu durumları gösterir.
Word2Vec gibi statik gömme yöntemleri, kelime başına bir vektör atar; bu nedenle "banka" kelimesi "nehir kıyısı" ve "banka hesabı"nda aynı şekilde temsil edilir. Bağlamsal modeller bu belirsizliği giderir, bu yüzden şu anda baskın konumdadırlar. Dezavantajı ise maliyettir: Bağlamsal bir vektör hesaplamak, tüm modeli çalıştırmayı gerektirir.
Comments
No comments yet. Be the first to share a thought.
Leave a comment