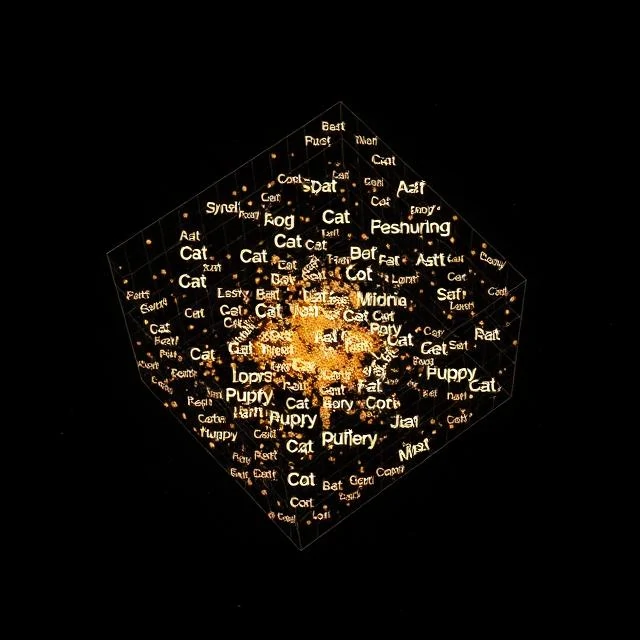
優れた単語埋め込みでは、「king」から「man」を引いて「woman」を足した単語は「queen」の近くに配置されます。この計算がうまくいくのは、ベクトルが単なる綴りだけでなく意味も符号化しているからです。各単語は、通常100から300次元の密な数値リストとなり、類似した単語がベクトル空間内で近くに配置されるように調整されます。
従来の表現方法では、単語は孤立した記号として扱われていました。「cat」という単語のワンホットベクトルは、「kitten」という単語については何も示していませんでした。埋め込み表現は、大規模なテキストコーパスで学習することでこの状況を変えました。つまり、似たような文脈で出現する単語は、似たようなベクトルを持つようになるのです。おおよそ「単語は、それが一緒に使われる単語によってわかる」という分布仮説が、このアイデア全体の原動力となっています。
一般的な方法
- Word2Vecは、その近傍の単語から単語を予測したり、その逆を行ったりします。
- GloVeは、グローバル共起行列を考慮に入れています。
- FastTextは、単語を文字nグラムの集合として表現する。
- BERTや類似モデルによる文脈埋め込みでは、単語のベクトルはその単語が属する文に依存する。
Word2Vecのような静的埋め込みでは、単語ごとに1つのベクトルが割り当てられるため、「bank」は「river bank」と「bank account」で同じ表現になります。コンテキストモデルはこの曖昧さを解消するため、現在では主流となっています。ただし、トレードオフとしてコストがかかります。コンテキストベクトルを計算するには、モデル全体を実行する必要があるからです。
Comments
No comments yet. Be the first to share a thought.
Leave a comment