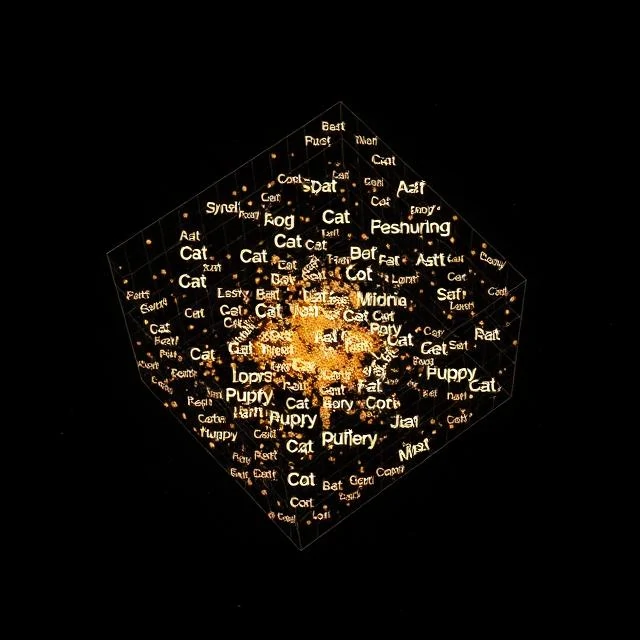
En una buena representación vectorial de palabras, "rey" menos "hombre" más "mujer" se sitúa cerca de "reina". Esta aritmética funciona porque los vectores codifican el significado, no solo la ortografía. Cada palabra se convierte en una lista densa de números, normalmente de 100 a 300 dimensiones, posicionados de forma que las palabras similares se encuentren cerca unas de otras en el espacio vectorial.
Las representaciones antiguas trataban las palabras como símbolos aislados. Un vector one-hot para "gato" no decía nada sobre "gatito". Las incrustaciones cambiaron esto al entrenarse con grandes corpus de texto: las palabras que aparecen en contextos similares terminan con vectores similares. La hipótesis distribucional, que se resume en "conocerás una palabra por las compañías que frecuenta", es el motor de toda la idea.
Métodos populares
- Word2Vec, que predice una palabra a partir de sus vecinos o viceversa.
- GloVe, que tiene en cuenta una matriz de coocurrencia global.
- FastText, que representa las palabras como bolsas de n-gramas de caracteres.
- Incrustaciones contextuales de BERT y modelos similares, donde el vector de una palabra depende de su oración.
Los modelos de incrustación estática como Word2Vec asignan un vector por palabra, por lo que "bank" tiene la misma representación en "river bank" y "bank account". Los modelos contextuales corrigen esa ambigüedad, razón por la cual ahora predominan. La desventaja es el costo: calcular un vector contextual requiere ejecutar todo el modelo.
Comments
No comments yet. Be the first to share a thought.
Leave a comment