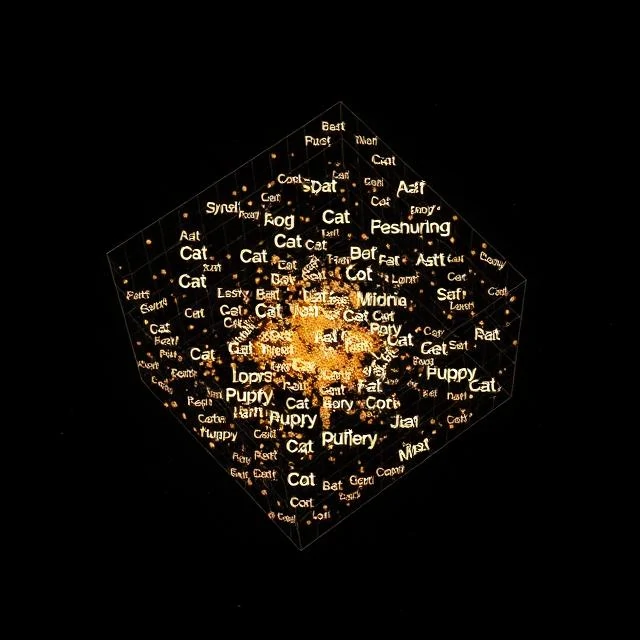
Bei einer guten Wortvektorisierung liegt die Differenz zwischen „König“ und „Mann“ plus „Frau“ nahe bei „Königin“. Diese Berechnung funktioniert, weil die Vektoren nicht nur die Schreibweise, sondern auch die Bedeutung kodieren. Jedes Wort wird zu einer dichten Liste von Zahlen, typischerweise 100 bis 300 Dimensionen, die so angeordnet sind, dass ähnliche Wörter im Vektorraum nahe beieinander liegen.
Ältere Darstellungsformen behandelten Wörter als isolierte Symbole. Ein One-Hot-Vektor für „Katze“ sagte nichts über „Kätzchen“ aus. Embeddings änderten dies durch das Training mit großen Textkorpora: Wörter, die in ähnlichen Kontexten vorkommen, erhalten ähnliche Vektoren. Die Verteilungshypothese, grob gesagt „Man erkennt ein Wort an den Wörtern, mit denen es zusammen vorkommt“, ist die Grundlage dieser Idee.
Gängige Methoden
- Word2Vec, das ein Wort anhand seiner Nachbarn vorhersagt oder umgekehrt
- GloVe, das eine globale Ko-Okkurrenzmatrix berücksichtigt
- FastText, das Wörter als Mengen von Zeichen-n-Grammen darstellt
- Kontextuelle Einbettungen von BERT und ähnlichen Modellen, bei denen der Vektor eines Wortes von seinem Satz abhängt
Statische Einbettungen wie Word2Vec ordnen jedem Wort einen Vektor zu, sodass „Bank“ in „Flussufer“ und „Bankkonto“ dieselbe Repräsentation hat. Kontextuelle Modelle beheben diese Mehrdeutigkeit, weshalb sie heute dominieren. Der Nachteil sind die Kosten: Die Berechnung eines Kontextvektors erfordert die Ausführung des gesamten Modells.
Comments
No comments yet. Be the first to share a thought.
Leave a comment