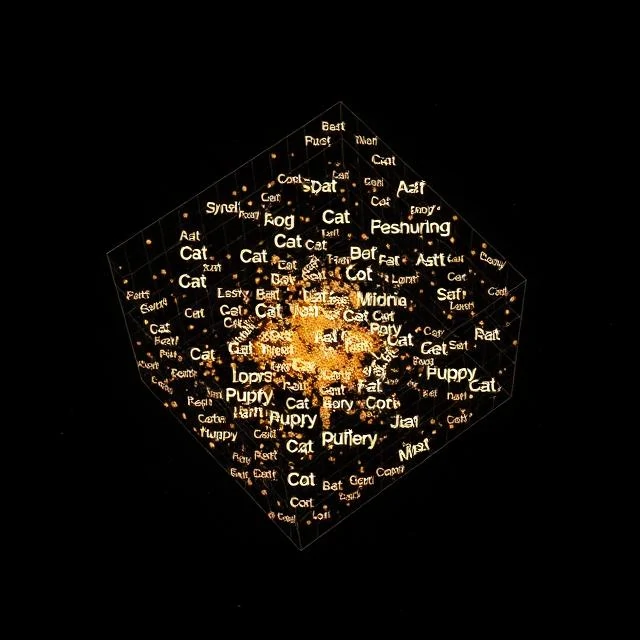
W dobrym słowie „embedding” „król” minus „mężczyzna” plus „kobieta” ląduje obok „królowej”. Ta arytmetyka działa, ponieważ wektory kodują znaczenie, a nie tylko pisownię. Każde słowo staje się gęstą listą liczb, zazwyczaj o 100 do 300 wymiarach, rozmieszczonych tak, że podobne słowa znajdują się blisko siebie w przestrzeni wektorowej.
Starsze reprezentacje traktowały słowa jako izolowane symbole. Wektor jednoskładnikowy dla słowa „kot” nie mówił nic o „kotku”. Osadzenie zmieniło to poprzez trenowanie na dużych korpusach tekstowych: słowa pojawiające się w podobnych kontekstach kończą się podobnymi wektorami. Hipoteza dystrybucyjna, mniej więcej „poznasz słowo po towarzystwie, w jakim się obraca”, jest motorem napędowym całej tej idei.
Popularne metody
- Word2Vec, który przewiduje słowo na podstawie słów sąsiadujących i odwrotnie
- GloVe, który uwzględnia globalną macierz współwystępowania
- FastText, który reprezentuje słowa jako zbiory n-gramów znaków
- Osadzenia kontekstowe z modeli BERT i podobnych, w których wektor słowa zależy od zdania
Statyczne osadzenia, takie jak Word2Vec, przypisują jeden wektor do słowa, więc „bank” ma tę samą reprezentację w wyrażeniach „brzeg rzeki” i „konto bankowe”. Modele kontekstowe rozwiązują tę niejednoznaczność i dlatego obecnie dominują. Kompromisem jest koszt: obliczenie wektora kontekstowego wymaga uruchomienia całego modelu.
Comments
No comments yet. Be the first to share a thought.
Leave a comment