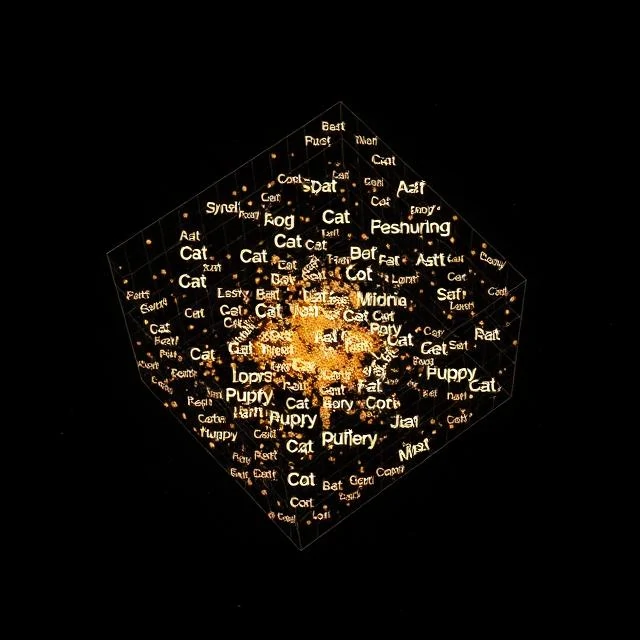
I en god ordindlejring lander "konge" minus "mand" plus "kvinde" nær "dronning". Denne aritmetik fungerer, fordi vektorerne koder betydning, ikke kun stavning. Hvert ord bliver en tæt liste af tal, typisk 100 til 300 dimensioner, placeret således at lignende ord sidder tæt sammen i vektorrummet.
Ældre repræsentationer behandlede ord som isolerede symboler. En one-hot vektor for "kat" sagde intet om "killing". Indlejringer ændrede dette ved at træne på store tekstkorpora: ord, der optræder i lignende kontekster, ender med lignende vektorer. Distributionshypotesen, groft sagt "du skal kende et ord på det selskab, det opbevarer", er motoren bag hele ideen.
Populære metoder
- Word2Vec, som forudsiger et ord fra dets naboer eller omvendt
- GloVe, som faktoriserer en global samforekomstmatrix
- FastText, som repræsenterer ord som poser med tegn-n-grammer
- Kontekstuelle indlejringer fra BERT og lignende modeller, hvor et ords vektor afhænger af dets sætning
Statiske indlejringer som Word2Vec tildeler én vektor pr. ord, så "bank" har den samme repræsentation i "flodbank" og "bankkonto". Kontekstuelle modeller retter op på denne tvetydighed, hvilket er grunden til, at de nu dominerer. Afvejningen er omkostninger: beregning af en kontekstuel vektor kræver kørsel af hele modellen.
Comments
No comments yet. Be the first to share a thought.
Leave a comment