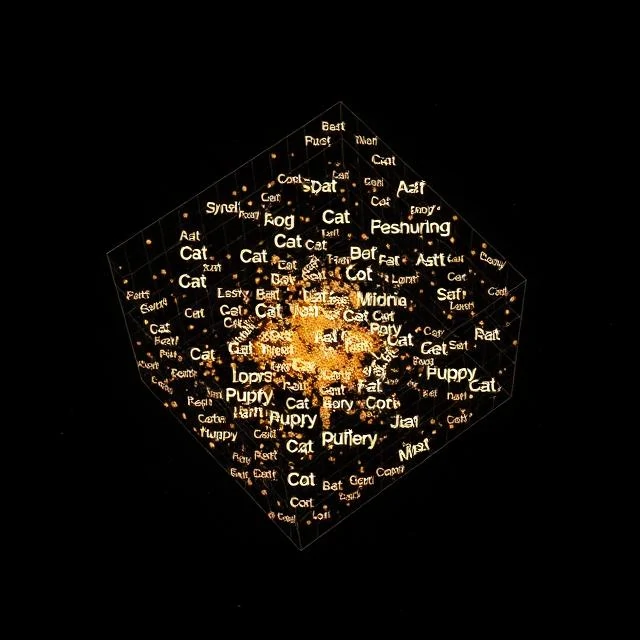
Dalam word embedding yang baik, "king" dikurangi "man" ditambah "woman" akan berada di dekat "queen." Perhitungan ini berhasil karena vektor-vektor tersebut mengkodekan makna, bukan hanya ejaan. Setiap kata menjadi daftar angka yang padat, biasanya 100 hingga 300 dimensi, yang diposisikan sedemikian rupa sehingga kata-kata yang serupa berada berdekatan dalam ruang vektor.
Representasi lama memperlakukan kata sebagai simbol yang terisolasi. Vektor one-hot untuk "kucing" tidak menjelaskan apa pun tentang "anak kucing". Embedding mengubah hal itu dengan melatih model pada korpus teks yang besar: kata-kata yang muncul dalam konteks serupa akan memiliki vektor yang serupa. Hipotesis distribusi, secara kasar "Anda akan mengenal sebuah kata dari konteksnya", adalah pendorong di balik keseluruhan gagasan ini.
Metode populer
- Word2Vec, yang memprediksi sebuah kata dari kata-kata di sekitarnya atau sebaliknya.
- GloVe, yang memperhitungkan matriks kemunculan bersama global.
- FastText, yang merepresentasikan kata-kata sebagai kumpulan n-gram karakter.
- Penyematan kontekstual dari BERT dan model serupa, di mana vektor suatu kata bergantung pada kalimatnya.
Embedding statis seperti Word2Vec menetapkan satu vektor per kata, sehingga "bank" memiliki representasi yang sama dalam "tepi sungai" dan "rekening bank". Model kontekstual memperbaiki ambiguitas tersebut, itulah sebabnya model ini sekarang mendominasi. Kelemahannya adalah biaya: menghitung vektor kontekstual membutuhkan eksekusi seluruh model.
Comments
No comments yet. Be the first to share a thought.
Leave a comment