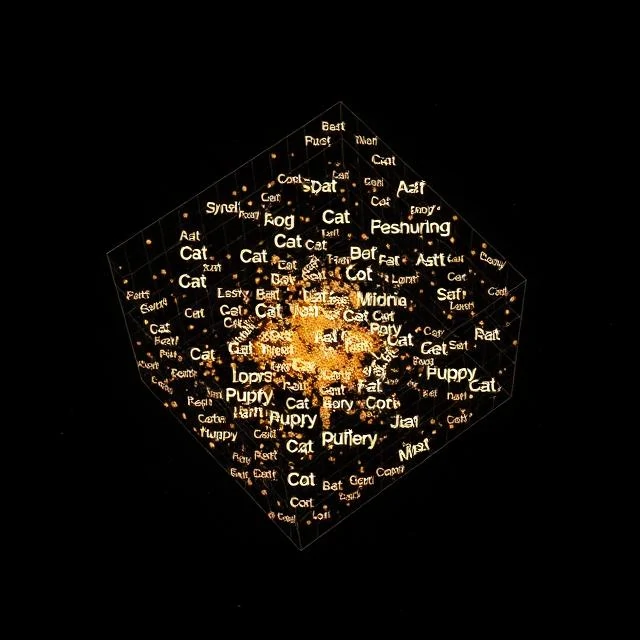
Num bom modelo de incorporação de palavras, "rei" menos "homem" mais "mulher" resulta em algo próximo de "rainha". Esta aritmética funciona porque os vetores codificam o significado, e não apenas a ortografia. Cada palavra torna-se uma lista densa de números, normalmente de 100 a 300 dimensões, posicionada de forma a que palavras semelhantes fiquem próximas umas das outras no espaço vetorial.
As representações mais antigas tratavam as palavras como símbolos isolados. Um vetor one-hot para "gato" não dizia nada sobre "gatinho". Os embeddings mudaram isso ao serem treinados em grandes corpora de texto: palavras que aparecem em contextos semelhantes acabam por ter vetores semelhantes. A hipótese distribucional, que em termos gerais significa "conhecemos uma palavra pela companhia que ela mantém", é o motor por detrás de toda a ideia.
Métodos populares
- Word2Vec, que prevê uma palavra a partir das suas vizinhas ou vice-versa.
- GloVe, que fatoriza uma matriz de coocorrência global
- FastText, que representa as palavras como conjuntos de n-gramas de caracteres.
- Incorporações contextuais do BERT e modelos similares, em que o vetor de uma palavra depende da sua frase.
Incorporações estáticas como o Word2Vec atribuem um vetor por palavra, pelo que "bank" tem a mesma representação em "river bank" e "bank account". Os modelos contextuais resolvem esta ambiguidade, e é por isso que dominam agora o mercado. A desvantagem é o custo: calcular um vetor contextual exige executar todo o modelo.
Comments
No comments yet. Be the first to share a thought.
Leave a comment