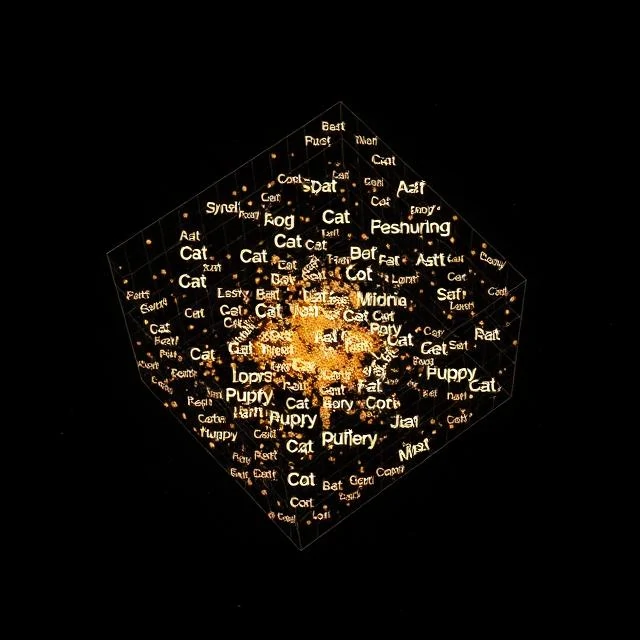
단어 임베딩을 잘 활용하면 "king"에서 "man"을 빼고 "woman"을 더한 값이 "queen" 근처에 위치하게 됩니다. 이러한 연산이 가능한 이유는 벡터가 단순히 철자뿐 아니라 의미까지 인코딩하기 때문입니다. 각 단어는 일반적으로 100~300차원의 밀집된 숫자 목록이 되며, 유사한 단어들이 벡터 공간에서 서로 가까이 위치하도록 배치됩니다.
이전 표현 방식에서는 단어를 독립적인 기호로 취급했습니다. "고양이"에 대한 원핫 벡터는 "새끼 고양이"에 대한 정보를 전혀 제공하지 않았습니다. 임베딩은 대규모 텍스트 코퍼스를 학습하여 이러한 문제를 해결했습니다. 유사한 맥락에서 나타나는 단어들은 유사한 벡터를 갖게 됩니다. "단어는 함께 쓰이는 단어들을 통해 알 수 있다"는 분포 가설이 이 아이디어의 핵심입니다.
인기 있는 방법
- Word2Vec은 주변 단어를 통해 단어를 예측하거나 반대로 주변 단어를 통해 단어를 예측하는 프로그램입니다.
- GloVe는 전역 동시 발생 행렬을 분석합니다.
- FastText는 단어를 문자 n-그램 묶음으로 표현합니다.
- BERT 및 유사 모델의 문맥 임베딩에서는 단어의 벡터가 해당 단어가 속한 문장에 따라 달라집니다.
Word2Vec과 같은 정적 임베딩은 단어당 하나의 벡터를 할당하므로 "bank"는 "river bank"와 "bank account"에서 동일한 표현을 갖습니다. 문맥 기반 모델은 이러한 모호성을 해결하며, 이것이 현재 문맥 기반 모델이 지배적인 이유입니다. 하지만 단점은 비용입니다. 문맥 벡터를 계산하려면 전체 모델을 실행해야 합니다.
Comments
No comments yet. Be the first to share a thought.
Leave a comment