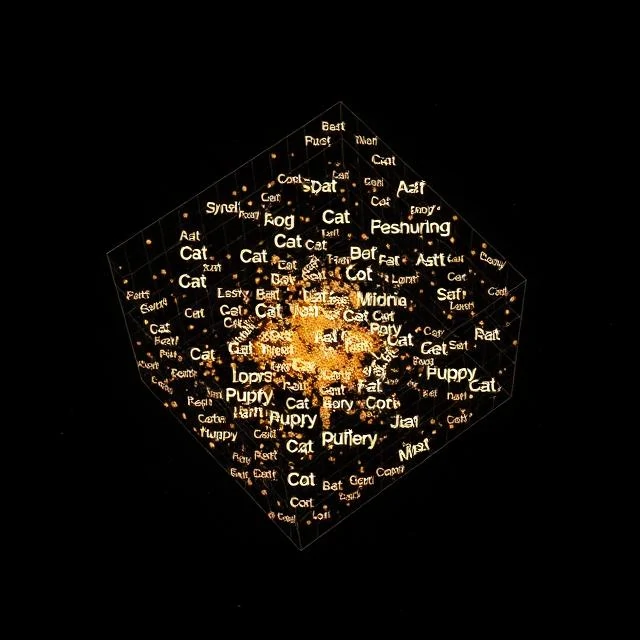
Dans un bon modèle d'intégration de mots, « roi » moins « homme » plus « femme » se rapproche de « reine ». Ce calcul est valable car les vecteurs encodent le sens, et non seulement l'orthographe. Chaque mot devient une liste dense de nombres, généralement de 100 à 300 dimensions, positionnés de sorte que les mots similaires soient proches les uns des autres dans l'espace vectoriel.
Les anciennes représentations traitaient les mots comme des symboles isolés. Un vecteur one-hot pour « chat » ne disait rien sur « chaton ». Les plongements lexicaux ont changé la donne grâce à l'apprentissage sur de vastes corpus textuels : les mots apparaissant dans des contextes similaires se retrouvent avec des vecteurs similaires. L'hypothèse distributionnelle, qui signifie en substance « on reconnaît un mot à son contexte », est le principe fondamental de cette approche.
méthodes populaires
- Word2Vec, qui prédit un mot à partir de ses voisins ou vice versa
- GloVe, qui factorise une matrice de cooccurrence globale
- FastText, qui représente les mots comme des sacs de n-grammes de caractères
- Les représentations contextuelles issues de BERT et de modèles similaires, où le vecteur d'un mot dépend de sa phrase.
Les plongements lexicaux statiques comme Word2Vec attribuent un vecteur par mot ; ainsi, « banque » est représenté de la même manière dans « rive » et « compte bancaire ». Les modèles contextuels lèvent cette ambiguïté, ce qui explique leur prédominance actuelle. Le principal inconvénient réside dans le coût : le calcul d’un vecteur contextuel nécessite l’exécution du modèle complet.
Comments
No comments yet. Be the first to share a thought.
Leave a comment