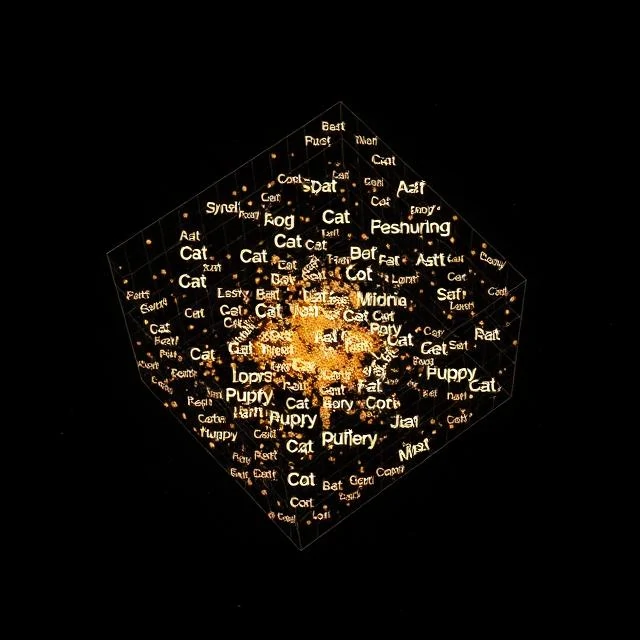
Bij een goede woordembedding komt "koning" min "man" plus "vrouw" uit op "koningin". Die berekening werkt omdat de vectoren betekenis coderen, niet alleen de spelling. Elk woord wordt een dichte lijst van getallen, meestal met 100 tot 300 dimensies, zo gepositioneerd dat gelijksoortige woorden dicht bij elkaar liggen in de vectorruimte.
Oudere representaties behandelden woorden als geïsoleerde symbolen. Een one-hot vector voor "kat" zei niets over "kitten". Embeddings hebben dat veranderd door te trainen op grote tekstcorpora: woorden die in vergelijkbare contexten voorkomen, krijgen vergelijkbare vectoren. De distributionele hypothese, grofweg "je herkent een woord aan de context waarin het voorkomt", vormt de drijvende kracht achter dit hele idee.
Populaire methoden
- Word2Vec voorspelt een woord op basis van de omliggende woorden of andersom.
- GloVe, dat een globale co-occurrence-matrix gebruikt.
- FastText, dat woorden weergeeft als verzamelingen van karakter-n-grammen.
- Contextuele embeddings van BERT en vergelijkbare modellen, waarbij de vector van een woord afhangt van de zin waarin het voorkomt.
Statische embeddings zoals Word2Vec kennen één vector per woord toe, waardoor "bank" dezelfde representatie heeft in "rivieroever" en "bankrekening". Contextuele modellen lossen die ambiguïteit op, en daarom zijn ze nu dominant. De keerzijde is de kosten: het berekenen van een contextuele vector vereist het uitvoeren van het volledige model.
Comments
No comments yet. Be the first to share a thought.
Leave a comment