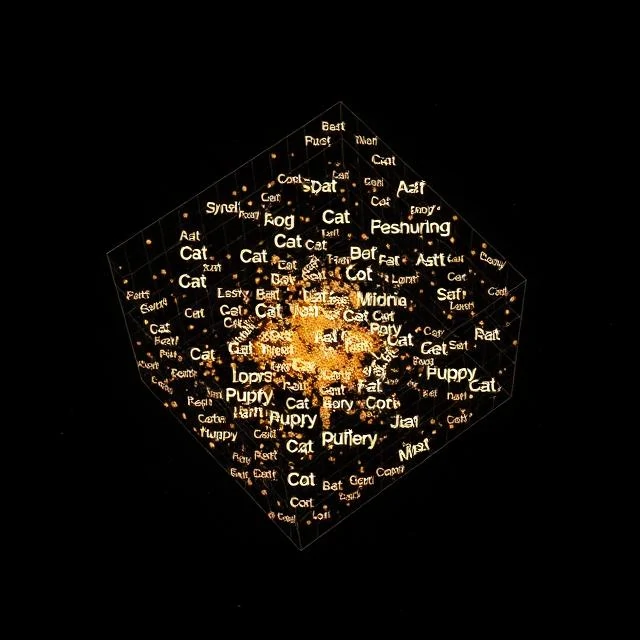
Egy jó szókapcsolatban a „király” mínusz a „férfi” plusz a „nő” szó összeadása a „királynő” szó mellé kerül. Ez a számtan azért működik, mert a vektorok jelentést is kódolnak, nem csak a helyesírást. Minden szó egy sűrű számlistává válik, jellemzően 100-300 dimenziósak, úgy elhelyezve, hogy a hasonló szavak közel legyenek egymáshoz a vektortérben.
A régebbi reprezentációk a szavakat elszigetelt szimbólumokként kezelték. A „macska” szó egyetlen lehetséges vektora semmit sem mondott a „cicáról”. A beágyazások ezt nagy szöveges korpuszokon való betanítással változtatták meg: a hasonló kontextusokban megjelenő szavak hasonló vektorokhoz kerülnek. Az eloszlási hipotézis, nagyjából „egy szót a társaságáról ismersz fel”, az egész ötlet motorja.
Népszerű módszerek
- Word2Vec, amely a szomszédos szavak alapján jósolja meg a szavakat, vagy fordítva.
- GloVe, amely egy globális együttes előfordulási mátrixot faktorál
- FastText, amely a szavakat karakteres n-gramok zsákjaiként ábrázolja
- Kontextuális beágyazások a BERT-ből és hasonló modellekből, ahol egy szó vektora a mondatától függ
A statikus beágyazások, mint például a Word2Vec, szavanként egy vektort rendelnek hozzá, így a „bank” ugyanazzal a reprezentációval rendelkezik a „folyópart” és a „bankszámla” esetében. A kontextuális modellek ezt a kétértelműséget kiküszöbölik, ezért dominálnak most. A kompromisszum a költség: egy kontextuális vektor kiszámítása a teljes modell futtatását igényli.
Comments
No comments yet. Be the first to share a thought.
Leave a comment