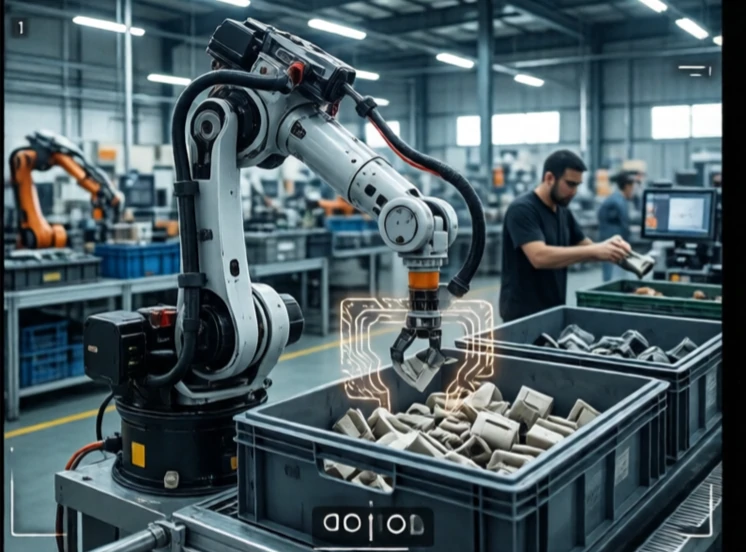
Recunoașterea obiectelor identifică ce se află într-o imagine sau într-o scanare de senzor. Este vorba de o persoană, o mașină, o ceașcă de cafea, un defect? Robotul trebuie să știe ce privește înainte de a putea decide ce să facă. Recunoașterea este primul pas în percepție.
Sistemele timpurii foloseau caracteristici create manual: muchii, colțuri, texturi. Acestea funcționau pentru obiecte specifice în condiții de iluminare controlată. Învățarea profundă a schimbat totul. Rețelele neuronale convoluționale învață caracteristici din date etichetate. O rețea antrenată pe milioane de imagini poate recunoaște mii de categorii de obiecte cu o precizie supraomenească în testele de referință. În lumea reală, performanța scade atunci când iluminarea se schimbă, obiectele se suprapun sau camera se mișcă.
Sarcini de recunoaștere a obiectelor
- Clasificare: ce este în imagine?
- Detectare: unde se află și ce este?
- Segmentare: ce pixeli aparțin obiectului?
- Estimarea poziției: cum este orientată?
- Urmărire: unde se mișcă în timp?
Un robot ar putea folosi recunoașterea pentru a alege o anumită piesă dintr-un container, pentru a evita un pieton sau pentru a inspecta o sudură pentru defecte. Provocarea este generalizarea. O rețea antrenată pe imagini însorite poate eșua noaptea. O rețea antrenată pe piesele unei fabrici poate eșua la cele ale alteia. Colectarea și augmentarea datelor sunt la fel de importante ca arhitectura modelului. Cele mai bune sisteme combină învățarea profundă cu raționamentul geometric și fuziunea senzorilor. O cameră ar putea recunoaște obiectul. Lidar-ul confirmă poziția acestuia. Senzorii de forță confirmă apucarea. Recunoașterea nu înseamnă doar să vezi. Este vorba despre înțelegerea a ceea ce trebuie să știe robotul.
Comments
No comments yet. Be the first to share a thought.
Leave a comment