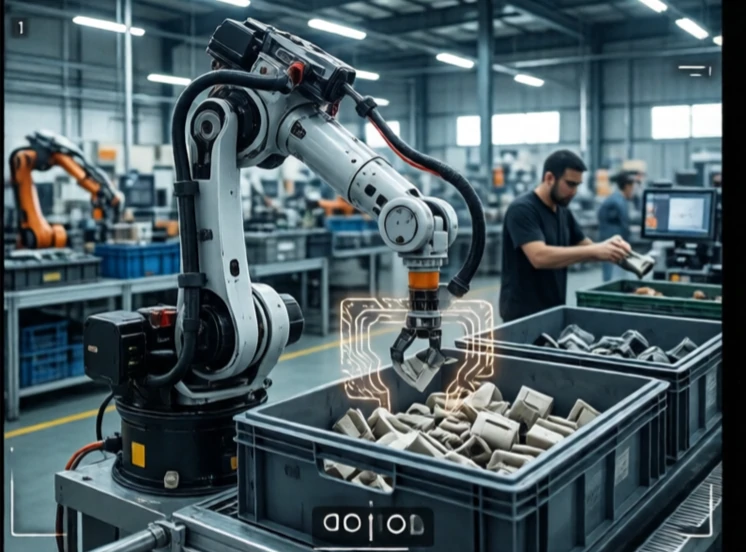
El reconocimiento de objetos identifica qué hay en una imagen o escaneo del sensor. ¿Es una persona, un coche, una taza de café, un defecto? El robot necesita saber qué está viendo antes de poder decidir qué hacer. El reconocimiento es el primer paso en la percepción.
Los primeros sistemas utilizaban características creadas manualmente: bordes, esquinas y texturas. Funcionaban para objetos específicos bajo iluminación controlada. El aprendizaje profundo lo cambió todo. Las redes neuronales convolucionales aprenden características a partir de datos etiquetados. Una red entrenada con millones de imágenes puede reconocer miles de categorías de objetos con una precisión sobrehumana en pruebas de referencia. En el mundo real, el rendimiento disminuye cuando cambia la iluminación, los objetos se superponen o la cámara se mueve.
Tareas de reconocimiento de objetos
- Clasificación: ¿qué hay en la imagen?
- Detección: ¿dónde está y qué es?
- Segmentación: ¿qué píxeles pertenecen al objeto?
- Estimación de la pose: ¿cómo se orienta?
- Seguimiento: ¿cómo se desplaza con el tiempo?
Un robot podría usar el reconocimiento para seleccionar una pieza específica de un contenedor, evitar a un peatón o inspeccionar una soldadura en busca de defectos. El desafío radica en la generalización. Una red entrenada con imágenes de luz diurna puede fallar de noche. Una red entrenada con piezas de una fábrica puede fallar con las de otra. La recopilación y el aumento de datos son tan importantes como la arquitectura del modelo. Los mejores sistemas combinan el aprendizaje profundo con el razonamiento geométrico y la fusión de sensores. Una cámara podría reconocer el objeto. El LiDAR confirma su posición. Los sensores de fuerza confirman el agarre. El reconocimiento no se trata solo de ver. Se trata de comprender lo que el robot necesita saber.
Comments
No comments yet. Be the first to share a thought.
Leave a comment