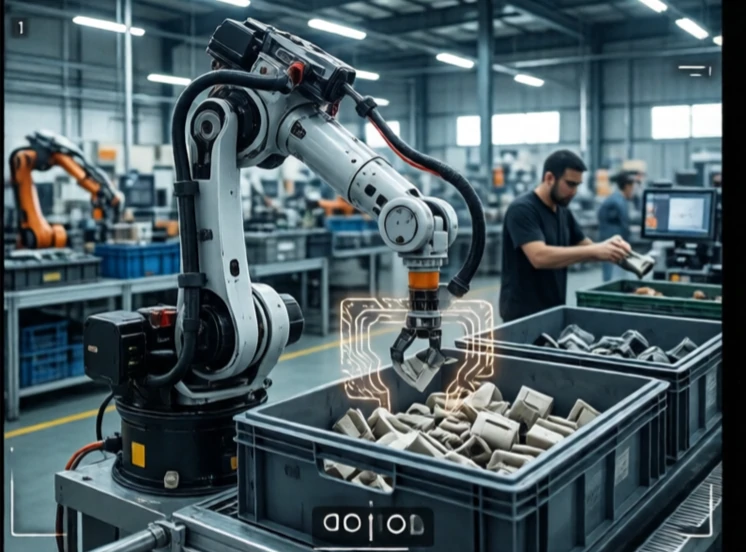
物体認識とは、画像やセンサーのスキャン画像に何が写っているかを識別することです。それは人なのか、車なのか、コーヒーカップなのか、それとも欠陥なのか?ロボットは、何をすべきかを判断する前に、何を見ているのかを知る必要があります。認識は知覚の第一歩です。
初期のシステムは、エッジ、コーナー、テクスチャといった手作業で作成された特徴量を使用していました。それらは、制御された照明条件下で特定の物体を認識するのに有効でした。ディープラーニングはすべてを変えました。畳み込みニューラルネットワークは、ラベル付きデータから特徴量を学習します。数百万枚の画像でトレーニングされたネットワークは、ベンチマークテストで人間を凌駕する精度で数千もの物体カテゴリを認識できます。現実世界では、照明の変化、物体の重なり、カメラの動きなどによって性能が低下します。
物体認識タスク
- 分類:画像には何が写っているのか?
- 検出:それはどこにあり、何なのか?
- セグメンテーション:どのピクセルがオブジェクトに属するのか?
- 姿勢推定:どのような向きになっているか?
- 追跡:時間の経過とともにどこへ移動するのか?
ロボットは認識機能を使って、容器から特定の部品を取り出したり、歩行者を避けたり、溶接部の欠陥を検査したりすることができる。課題は汎化性能だ。日中の晴天時の画像で学習させたネットワークは、夜間には機能しない可能性がある。ある工場の部品で学習させたネットワークは、別の工場の部品では機能しない可能性がある。データ収集とデータ拡張は、モデルアーキテクチャと同じくらい重要だ。最良のシステムは、深層学習と幾何学的推論、センサーフュージョンを組み合わせている。カメラが物体を認識し、LiDARがその位置を確認し、力覚センサーが把持を確認する。認識とは、単に物を見ることではない。ロボットが何を知る必要があるかを理解することなのだ。
Comments
No comments yet. Be the first to share a thought.
Leave a comment