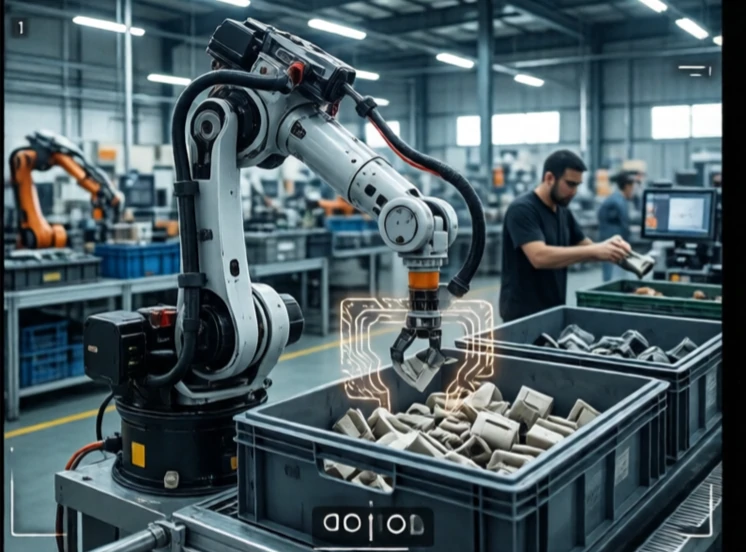
객체 인식은 이미지나 센서 스캔에서 무엇이 보이는지 식별하는 과정입니다. 사람인지, 자동차인지, 커피잔인지, 아니면 결함인지 등을 파악하는 것이죠. 로봇은 무엇을 해야 할지 결정하기 전에 무엇을 보고 있는지 알아야 합니다. 인식은 지각의 첫 번째 단계입니다.
초기 시스템은 모서리, 모서리, 질감과 같은 특징을 수작업으로 추출했습니다. 이러한 시스템은 특정 객체에 대해서는 제어된 조명 조건에서만 작동했습니다. 하지만 딥러닝은 모든 것을 바꿔놓았습니다. 합성곱 신경망은 레이블이 지정된 데이터로부터 특징을 학습합니다. 수백만 장의 이미지로 학습된 네트워크는 벤치마크 테스트에서 인간을 초월하는 정확도로 수천 가지 객체 범주를 인식할 수 있습니다. 그러나 실제 환경에서는 조명이 변하거나, 객체가 겹치거나, 카메라가 움직일 때 성능이 저하됩니다.
객체 인식 작업
- 분류: 이미지에는 무엇이 들어 있습니까?
- 탐지: 어디에 있으며, 무엇인가?
- 분할: 어떤 픽셀이 객체에 속하는가?
- 자세 추정: 방향은 어떻게 정해지는가?
- 추적: 시간이 지남에 따라 어디로 이동하는가?
로봇은 인식 기술을 사용하여 보관함에서 특정 부품을 집어내거나, 보행자를 피하거나, 용접 부위의 결함을 검사할 수 있습니다. 여기서 중요한 과제는 일반화 능력입니다. 밝은 낮에 촬영한 이미지로 학습된 네트워크가 밤에는 제대로 작동하지 않을 수 있습니다. 한 공장의 부품으로 학습된 네트워크가 다른 공장의 부품에는 제대로 작동하지 않을 수도 있습니다. 데이터 수집 및 증강은 모델 아키텍처만큼 중요합니다. 최고의 시스템은 딥러닝과 기하학적 추론, 센서 융합을 결합합니다. 카메라가 물체를 인식하면, 라이다가 위치를 확인하고, 힘 센서가 파지 여부를 확인합니다. 인식은 단순히 보는 것만이 아니라 로봇이 알아야 할 정보를 이해하는 것입니다.
Comments
No comments yet. Be the first to share a thought.
Leave a comment