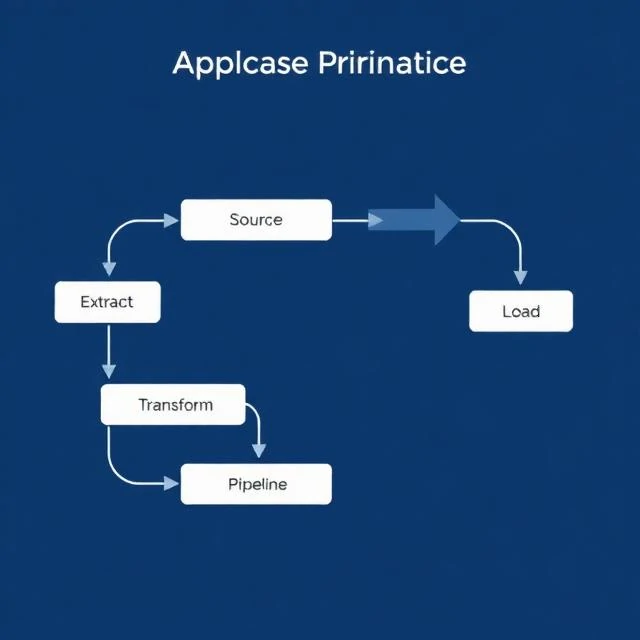
数据管道通过一系列步骤将数据从源端移动到目标端。首先从源端提取数据,然后将其转换为目标格式,加载到存储设备中,最后使其可用于分析。管道可以按计划自动运行,也可以响应事件自动运行。它负责处理繁琐的底层工作,使分析师和数据科学家能够专注于使用数据,而不是移动数据。
流水线的复杂程度不一。一个每晚复制 CSV 文件的作业就是一个流水线。一个每秒处理数百万个事件的流式系统也是一个流水线。使用的工具也多种多样:Airflow、Dagster 和 Prefect 用于编排;Kafka、Kinesis 和 Pub/Sub 用于流式传输;dbt 用于数据转换。但挑战却始终如一:数据源会毫无预警地发生变化;数据到达时间延迟或格式错误;作业在凌晨两点失败,直到晨报为空才有人注意到。优秀的流水线具备监控、告警、重试逻辑以及幂等步骤,即使运行两次也不会重复数据。它们都有完善的文档,以便任何人都能理解其功能。它们经过测试,确保变更不会破坏下游系统。流水线是一种基础设施。与任何基础设施一样,当无需任何人操心时,它才能发挥最佳效用。
管道阶段
- 提取——从数据源提取数据
- 改造——清洁、丰富和重塑
- 加载——写入目标系统
- 统筹安排——安排和协调步骤
- 监控——检测故障并发出警报
数据管道是数据的供应链。如果它出现故障,下游的所有流程都会停止。
Comments
No comments yet. Be the first to share a thought.
Leave a comment