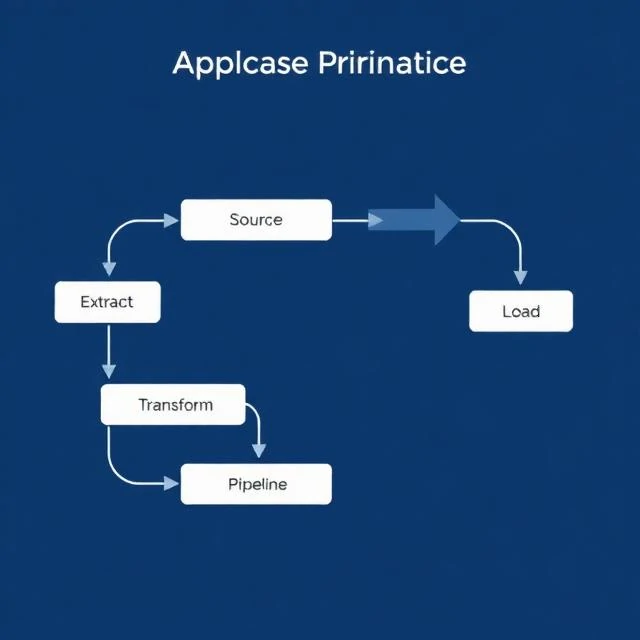
데이터 파이프라인은 일련의 단계를 거쳐 데이터를 소스에서 대상으로 이동시킵니다. 소스에서 데이터를 추출하고, 대상 형식에 맞게 변환한 후, 저장소에 저장하고, 분석에 사용할 수 있도록 만듭니다. 파이프라인은 자동으로, 정해진 일정에 따라 또는 특정 이벤트에 대응하여 실행됩니다. 파이프라인이 데이터 이동의 모든 과정을 처리해 주기 때문에 분석가와 데이터 과학자는 데이터 활용에 집중할 수 있습니다.
파이프라인은 단순한 것부터 복잡한 것까지 다양합니다. CSV 파일을 복사하는 야간 작업도 파이프라인이고, 초당 수백만 개의 이벤트를 처리하는 스트리밍 시스템도 파이프라인입니다. 사용되는 도구도 다양합니다. 오케스트레이션에는 Airflow, Dagster, Prefect 등이 있고, 스트리밍에는 Kafka, Kinesis, Pub/Sub 등이 있으며, 데이터 변환에는 dbt가 사용됩니다. 파이프라인 운영에는 항상 어려움이 따릅니다. 데이터 소스는 예고 없이 변경되고, 데이터는 늦게 도착하거나 형식이 잘못될 수 있습니다. 새벽 2시에 작업이 실패해도 아침 보고서가 텅 비어 있을 때까지 아무도 알아채지 못할 수도 있습니다. 잘 만들어진 파이프라인은 모니터링, 알림, 재시도 로직, 그리고 데이터 중복 없이 두 번 실행될 수 있는 멱등성 단계를 갖추고 있어야 합니다. 또한 누구나 이해할 수 있도록 문서화되어 있어야 하고, 변경 사항이 하위 시스템에 영향을 미치지 않도록 테스트되어야 합니다. 파이프라인은 인프라의 일종입니다. 다른 인프라와 마찬가지로, 아무도 신경 쓰지 않아도 될 때 가장 효율적으로 작동합니다.
파이프라인 단계
- 추출 — 소스에서 데이터를 가져옵니다.
- 변화시키다 — 깨끗하게 하고, 풍요롭게 하고, 재구성하다
- 로드 — 대상 시스템에 기록합니다.
- 오케스트레이션 — 단계들을 계획하고 조정합니다.
- 모니터링 - 오류를 감지하고 경고합니다.
데이터 파이프라인은 데이터의 공급망입니다. 파이프라인에 문제가 생기면 하위 시스템의 모든 것이 중단됩니다.
Comments
No comments yet. Be the first to share a thought.
Leave a comment