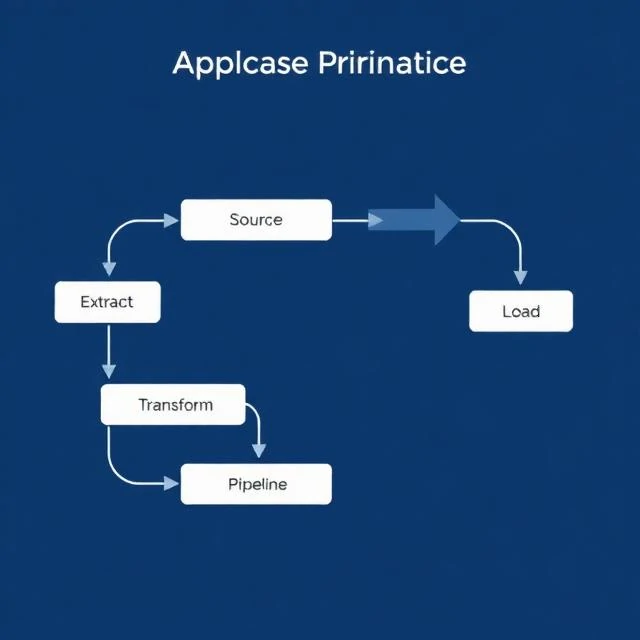
डेटा पाइपलाइन कई चरणों के माध्यम से स्रोत से गंतव्य तक डेटा पहुंचाती है। स्रोत से डेटा निकालें, उसे लक्ष्य के अनुरूप रूपांतरित करें, उसे संग्रहण में लोड करें, और फिर उसे विश्लेषण के लिए उपलब्ध कराएं। पाइपलाइन स्वचालित रूप से, निर्धारित समय पर या किसी घटना के जवाब में चलती है। यह बुनियादी ढांचे का प्रबंधन करती है ताकि विश्लेषक और डेटा वैज्ञानिक डेटा को स्थानांतरित करने के बजाय उसका उपयोग करने पर ध्यान केंद्रित कर सकें।
पाइपलाइन सरल से लेकर जटिल तक हो सकती हैं। CSV फ़ाइल की कॉपी बनाने वाला रात्रिकालीन कार्य एक पाइपलाइन है। प्रति सेकंड लाखों इवेंट प्रोसेस करने वाला स्ट्रीमिंग सिस्टम भी एक पाइपलाइन है। उपयोग किए जाने वाले उपकरण अलग-अलग होते हैं: ऑर्केस्ट्रेशन के लिए Airflow, Dagster, Prefect; स्ट्रीमिंग के लिए Kafka, Kinesis और Pub/Sub; और ट्रांसफ़ॉर्मेशन के लिए dbt। चुनौतियाँ एक जैसी ही रहती हैं। स्रोत बिना किसी पूर्व सूचना के बदल जाते हैं। डेटा देर से या गलत तरीके से आता है। कार्य रात 2 बजे विफल हो जाते हैं और सुबह की रिपोर्ट खाली होने तक किसी को पता नहीं चलता। अच्छी पाइपलाइनों में मॉनिटरिंग, अलर्टिंग, रिट्राई लॉजिक और ऐसे आइडम्पोटेंट स्टेप्स होते हैं जो डेटा को डुप्लिकेट किए बिना दो बार चल सकते हैं। इनका दस्तावेज़ीकरण किया जाता है ताकि हर कोई समझ सके कि ये क्या करते हैं। इनका परीक्षण किया जाता है ताकि बदलावों से डाउनस्ट्रीम सिस्टम खराब न हों। पाइपलाइन एक बुनियादी ढांचा है। किसी भी बुनियादी ढांचे की तरह, यह तब सबसे अच्छा काम करता है जब किसी को इसके बारे में सोचना न पड़े।
पाइपलाइन के चरण
- डेटा को स्रोतों से निकालें
- रूपांतरित करें — साफ करें, समृद्ध करें और नया आकार दें
- लोड करें — लक्ष्य प्रणाली पर लिखें
- व्यवस्थित करें — चरणों की समय-सारणी बनाएं और समन्वय करें
- मॉनिटर करें — विफलताओं का पता लगाएं और अलर्ट जारी करें
डेटा पाइपलाइन डेटा की आपूर्ति श्रृंखला है। यदि यह टूट जाती है, तो आगे की सारी प्रक्रिया रुक जाती है।
Comments
No comments yet. Be the first to share a thought.
Leave a comment