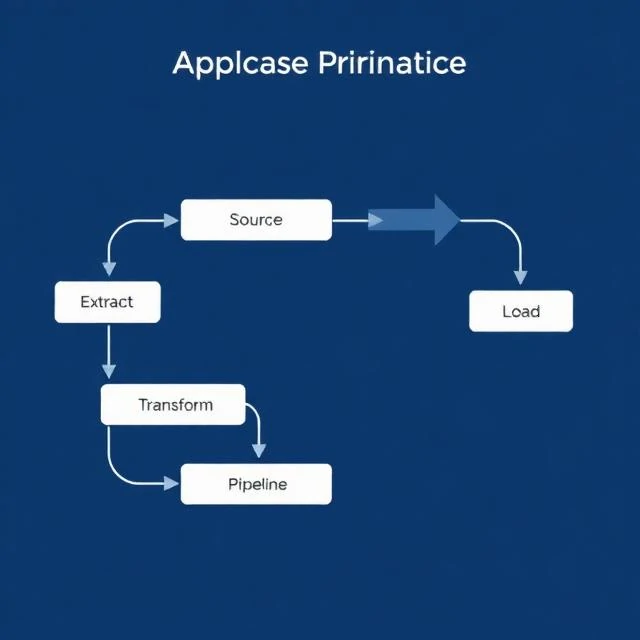
Eine Datenpipeline transportiert Daten in mehreren Schritten von der Quelle zum Ziel. Sie extrahiert die Daten aus der Quelle, transformiert sie für das Zielformat, lädt sie in den Speicher und stellt sie anschließend für die Analyse bereit. Die Pipeline läuft automatisch, nach einem Zeitplan oder ereignisgesteuert. Sie kümmert sich um die gesamte Infrastruktur, sodass sich Analysten und Data Scientists auf die Datennutzung konzentrieren können, anstatt Daten zu übertragen.
Pipelines reichen von einfach bis komplex. Ein nächtlicher Job, der eine CSV-Datei kopiert, ist eine Pipeline. Auch ein Streaming-System, das Millionen von Ereignissen pro Sekunde verarbeitet, ist eine Pipeline. Die Tools variieren: Airflow, Dagster und Prefect für die Orchestrierung; Kafka, Kinesis und Pub/Sub für das Streaming; dbt für die Transformation. Die Herausforderungen sind dieselben: Datenquellen ändern sich unerwartet. Daten treffen verspätet oder fehlerhaft ein. Jobs schlagen um 2 Uhr nachts fehl, und niemand bemerkt es, bis der Morgenbericht leer ist. Gute Pipelines verfügen über Überwachung, Alarmierung, Wiederholungslogik und idempotente Schritte, die zweimal ausgeführt werden können, ohne Daten zu duplizieren. Sie sind dokumentiert, sodass jeder ihre Funktionsweise versteht. Sie werden getestet, um sicherzustellen, dass Änderungen nachgelagerte Systeme nicht beeinträchtigen. Eine Pipeline ist Infrastruktur. Wie jede Infrastruktur funktioniert sie am besten, wenn sich niemand darum kümmern muss.
Pipeline-Phasen
- Extrahieren – Daten aus Quellen abrufen
- Transformieren – reinigen, anreichern und neu gestalten
- Laden – in das Zielsystem schreiben
- Orchestrieren – Schritte planen und koordinieren
- Überwachung – Fehler erkennen und bei Problemen Alarm schlagen
Eine Datenpipeline ist eine Lieferkette für Daten. Wenn sie ausfällt, steht alles nachgelagerte still.
Comments
No comments yet. Be the first to share a thought.
Leave a comment