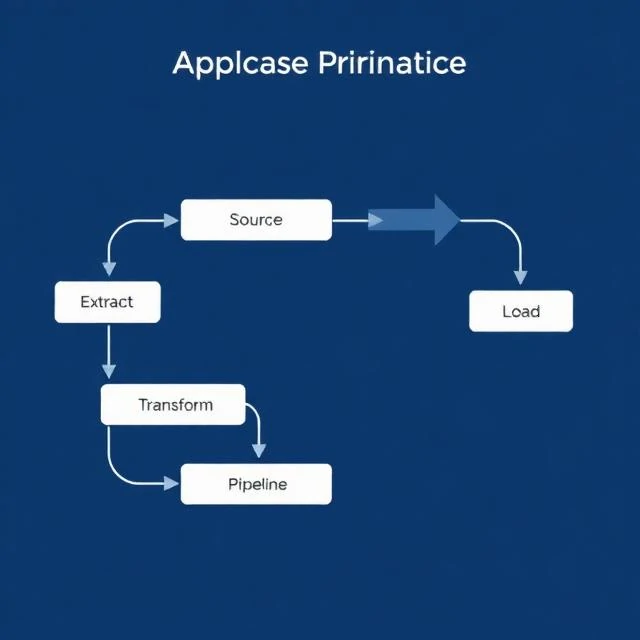
Un pipeline de données achemine les données de la source vers la destination en suivant une série d'étapes : extraction des données de la source, transformation pour les adapter au format cible, chargement dans le stockage, puis mise à disposition pour l'analyse. Le pipeline s'exécute automatiquement, selon une planification ou en réponse à des événements. Il gère l'infrastructure technique afin que les analystes et les data scientists puissent se concentrer sur l'utilisation des données plutôt que sur leur transfert.
Les pipelines peuvent être simples ou complexes. Une tâche nocturne copiant un fichier CSV est un pipeline. Un système de streaming traitant des millions d'événements par seconde en est un autre. Les outils varient : Airflow, Dagster et Prefect pour l'orchestration ; Kafka, Kinesis et Pub/Sub pour le streaming ; dbt pour la transformation des données. Les défis sont constants : les sources changent sans prévenir ; les données arrivent en retard ou corrompues ; des tâches échouent à 2 h du matin sans que personne ne s'en aperçoive avant que le rapport du lendemain matin ne soit vide. Les bons pipelines intègrent une surveillance, des alertes, une logique de nouvelle tentative et des étapes idempotentes pouvant s'exécuter deux fois sans duplication de données. Ils sont documentés pour que chacun puisse comprendre leur fonctionnement. Ils sont testés afin que les modifications n'affectent pas les systèmes en aval. Un pipeline est une infrastructure. Comme toute infrastructure, il fonctionne de manière optimale lorsqu'il est automatisé.
Étapes du pipeline
- Extraction — extraire des données des sources
- Transformer — nettoyer, enrichir et remodeler
- Charger — écrire sur le système cible
- Orchestrer — planifier et coordonner les étapes
- Surveillance — détecter et signaler les pannes
Un pipeline de données est une chaîne d'approvisionnement pour les données. S'il est interrompu, tout ce qui se trouve en aval s'arrête.
Comments
No comments yet. Be the first to share a thought.
Leave a comment