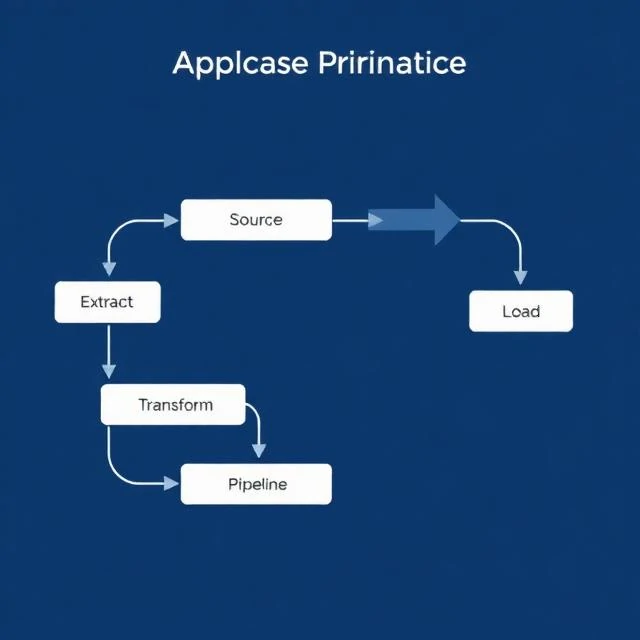
En datapipeline flyttar data från källa till destination genom en serie steg. Extrahera från källan. Transformera den för att passa målet. Ladda den till lagring. Gör den sedan tillgänglig för analys. Pipelinen körs automatiskt, enligt ett schema eller som svar på händelser. Den hanterar rörmokeriet så att analytiker och dataforskare kan fokusera på att använda data snarare än att flytta den.
Pipelines varierar från enkla till komplexa. Ett nattligt jobb som kopierar en CSV-fil är en pipeline. Ett streamingsystem som bearbetar miljontals händelser per sekund är också en pipeline. Verktygen varierar: Airflow, Dagster, Prefect för orkestrering. Kafka, Kinesis och Pub/Sub för streaming. dbt för transformation. Utmaningarna är konsekventa. Källor ändras utan förvarning. Data anländer sent eller är felaktigt formaterade. Jobb misslyckas klockan 02:00 och ingen märker det förrän morgonrapporten är tom. Bra pipelines har övervakning, varningar, logik för återförsök och idempotenta steg som kan köras två gånger utan att duplicera data. De dokumenteras så att vem som helst kan förstå vad de gör. De testas så att förändringar inte förstör nedströmssystem. En pipeline är infrastruktur. Liksom all infrastruktur fungerar den bäst när ingen behöver tänka på den.
Rörledningsfaser
- Extrahera — hämta data från källor
- Förvandla – rensa, berika och omforma
- Ladda — skriv till målsystemet
- Orkestrera — schemalägga och koordinera steg
- Övervaka — upptäck och varna vid fel
En datapipeline är en leveranskedja för data. Om den går sönder stannar allt nedströms.
Comments
No comments yet. Be the first to share a thought.
Leave a comment