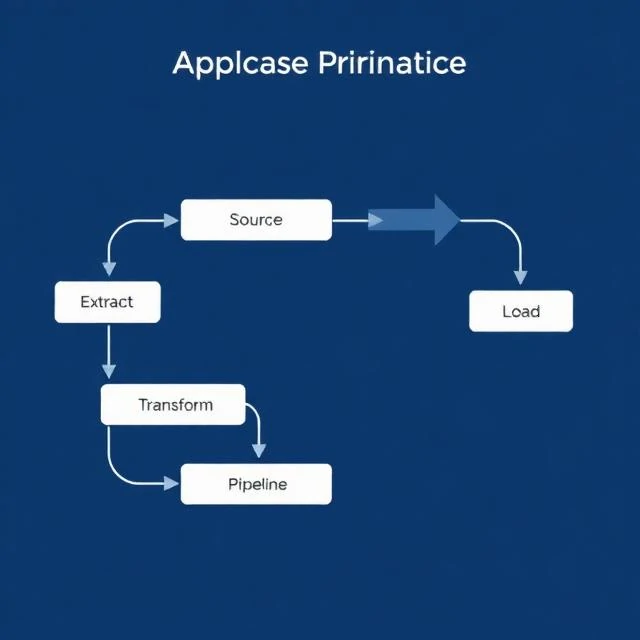
En datapipeline flytter data fra kilde til destinasjon gjennom en rekke trinn. Uttrekk fra kilden. Transformer dem slik at de passer til målet. Last dem inn i lagring. Gjør dem deretter tilgjengelige for analyse. Pipeline kjører automatisk, etter en tidsplan eller som svar på hendelser. Den håndterer rørleggerarbeidet slik at analytikere og dataforskere kan fokusere på å bruke dataene i stedet for å flytte dem.
Pipelines varierer fra enkle til komplekse. En nattlig jobb som kopierer en CSV-fil er en pipeline. Et strømmesystem som behandler millioner av hendelser per sekund er også en pipeline. Verktøyene varierer: Airflow, Dagster, Prefect for orkestrering. Kafka, Kinesis og Pub/Sub for strømming. dbt for transformasjon. Utfordringene er konsistente. Kilder endres uten forvarsel. Data ankommer sent eller er feilformede. Jobber mislykkes klokken 02.00, og ingen legger merke til det før morgenrapporten er tom. Gode pipelines har overvåkings-, varslings-, nytt forsøkslogikk og idempotente trinn som kan kjøres to ganger uten å duplisere data. De er dokumentert slik at alle kan forstå hva de gjør. De er testet slik at endringer ikke ødelegger nedstrømssystemer. En pipeline er infrastruktur. Som all infrastruktur fungerer den best når ingen trenger å tenke på den.
Rørledningstrinn
- Uttrekk – hente data fra kilder
- Transformer – rengjør, berik og omform
- Last inn – skriv til målsystemet
- Orkestrer – planlegg og koordiner trinn
- Overvåk – oppdag og varsle om feil
En datapipeline er en forsyningskjede for data. Hvis den brytes sammen, stopper alt nedstrøms.
Comments
No comments yet. Be the first to share a thought.
Leave a comment