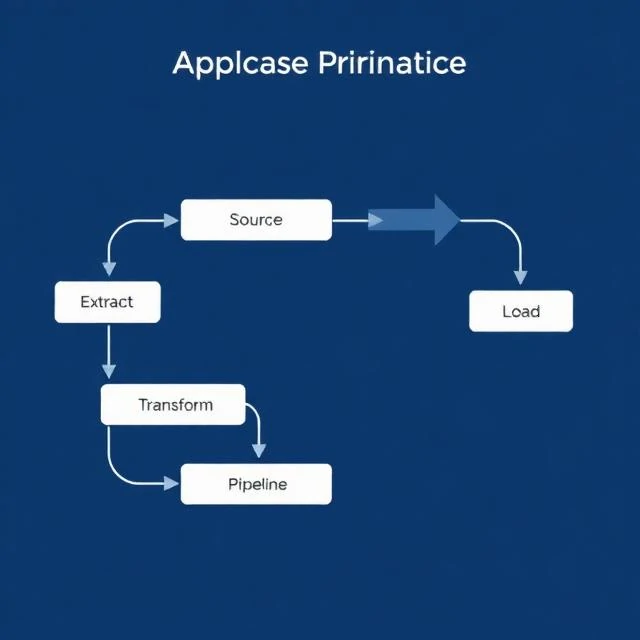
Конвейер обработки данных перемещает данные из источника в пункт назначения через ряд этапов. Извлечение из источника. Преобразование данных в соответствии с целевым значением. Загрузка в хранилище. Затем предоставление данных для анализа. Конвейер работает автоматически, по расписанию или в ответ на события. Он обеспечивает всю необходимую инфраструктуру, позволяя аналитикам и специалистам по обработке данных сосредоточиться на использовании данных, а не на их перемещении.
Конвейеры обработки данных бывают от простых до сложных. Ночная задача копирования CSV-файла — это конвейер. Система потоковой обработки, обрабатывающая миллионы событий в секунду, также является конвейером. Инструменты различаются: Airflow, Dagster, Prefect для оркестрации; Kafka, Kinesis и Pub/Sub для потоковой обработки; dbt для преобразования данных. Проблемы остаются неизменными. Источники меняются без предупреждения. Данные поступают с задержкой или в некорректном виде. Задачи завершаются с ошибкой в 2 часа ночи, и никто этого не замечает, пока утренний отчет не окажется пустым. Хорошие конвейеры имеют мониторинг, оповещения, логику повторных попыток и идемпотентные шаги, которые могут выполняться дважды без дублирования данных. Они документированы, чтобы любой мог понять, что они делают. Они протестированы, чтобы изменения не нарушали работу нижестоящих систем. Конвейер — это инфраструктура. Как и любая инфраструктура, он работает лучше всего, когда о нем не нужно думать.
Этапы трубопровода
- Извлечение — получение данных из источников
- Преобразуй — очисти, обогати и измени форму.
- Загрузка — запись в целевую систему
- Организация — планирование и координация этапов.
- Мониторинг — обнаружение и оповещение о сбоях.
Конвейер обработки данных — это цепочка поставок данных. Если он выйдет из строя, всё, что находится ниже по цепочке, остановится.
Comments
No comments yet. Be the first to share a thought.
Leave a comment