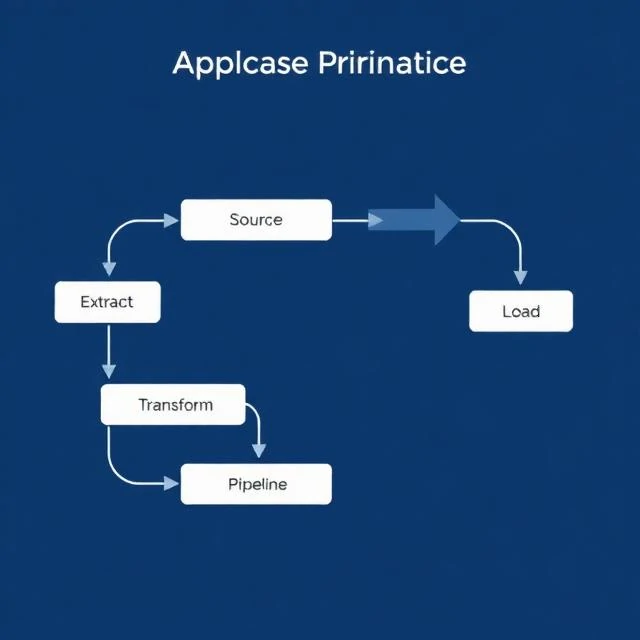
資料管道透過一系列步驟將資料從來源端移動到目標端。首先從來源端提取數據,然後將其轉換為目標格式,載入到儲存裝置中,最後使其可用於分析。管道可以按計劃自動運行,也可以響應事件自動運行。它負責處理繁瑣的底層工作,使分析師和數據科學家能夠專注於使用數據,而不是行動數據。
流水線的複雜程度不一。一個每晚複製 CSV 檔案的作業就是一個管線。一個每秒處理數百萬個事件的串流系統也是一個管線。使用的工具也多種多樣:Airflow、Dagster 和 Prefect 用於編排;Kafka、Kinesis 和 Pub/Sub 用於串流;dbt 用於資料轉換。但挑戰始終如一:資料來源會毫無預警地改變;資料到達時間延遲或格式錯誤;作業在凌晨兩點失敗,直到晨報為空才有人注意到。優秀的管線具備監控、警告、重試邏輯以及冪等步驟,即使運作兩次也不會重複資料。它們都有完善的文檔,以便任何人都能理解其功能。它們經過測試,確保變更不會破壞下游系統。流水線是一種基礎設施。就像任何基礎設施一樣,當無需任何人操心時,它才能發揮最佳效用。
管道階段
- 提取——從數據來源提取數據
- 改造-清潔、豐富與重塑
- 載入-寫入目標系統
- 統籌安排-安排和協調步驟
- 監控-偵測故障並發出警報
數據管道是數據的供應鏈。如果它出現故障,下游的所有流程都會停止。
Comments
No comments yet. Be the first to share a thought.
Leave a comment