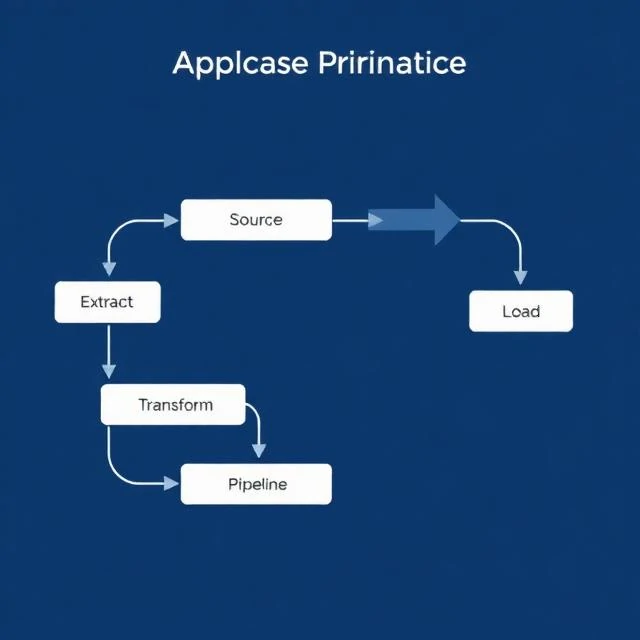
データパイプラインは、一連の手順を経て、データをソースから宛先へと移動させます。ソースからデータを抽出し、ターゲットに合わせて変換し、ストレージにロードし、分析に利用できるようにします。パイプラインは、スケジュールに基づいて、またはイベントに応じて自動的に実行されます。パイプラインが複雑な処理を担うことで、アナリストやデータサイエンティストはデータの移動ではなく、データの活用に集中できます。
パイプラインは単純なものから複雑なものまで様々です。毎晩CSVファイルをコピーするジョブもパイプラインです。毎秒数百万のイベントを処理するストリーミングシステムもパイプラインです。ツールも様々です。オーケストレーションにはAirflow、Dagster、Prefectなどがあります。ストリーミングにはKafka、Kinesis、Pub/Subなどがあります。データ変換にはdbtなどがあります。課題は共通しています。ソースは予告なく変更されます。データは遅れて到着したり、形式が間違っていたりします。ジョブが午前2時に失敗しても、朝のレポートが空になるまで誰も気づきません。優れたパイプラインには、監視、アラート、再試行ロジック、そしてデータを重複させることなく2回実行できる冪等ステップが備わっています。誰でも理解できるようにドキュメント化されています。変更によって下流のシステムが壊れないようにテストされています。パイプラインはインフラストラクチャです。他のインフラストラクチャと同様に、誰もそのことを気にしなくて済むときに最も効果的に機能します。
パイプラインの段階
- 抽出 — ソースからデータを取得する
- 変革する ― 浄化し、豊かにし、再構築する
- ロード — ターゲットシステムに書き込む
- オーケストレーション — 手順のスケジュール設定と調整
- 監視 — 障害を検知して警告を発する
データパイプラインはデータのサプライチェーンです。それが故障すると、下流のすべての処理が停止します。
Comments
No comments yet. Be the first to share a thought.
Leave a comment