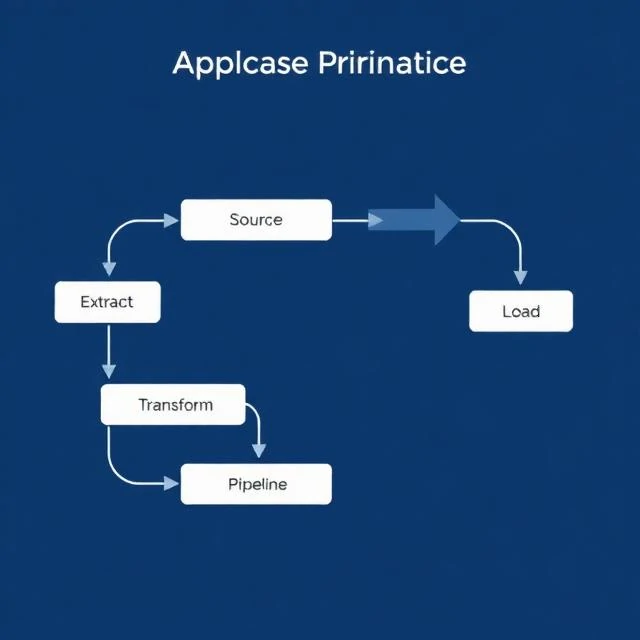
Przepływ danych przesyła dane ze źródła do miejsca docelowego, wykonując szereg kroków. Wyodrębnia dane ze źródła. Przekształca je, aby pasowały do celu. Ładuje je do pamięci masowej. Następnie udostępnia do analizy. Przepływ danych działa automatycznie, zgodnie z harmonogramem lub w reakcji na zdarzenia. Zarządza przepływem danych, dzięki czemu analitycy i naukowcy zajmujący się danymi mogą skupić się na korzystaniu z danych, a nie na ich przesyłaniu.
Potoki danych różnią się od prostych do złożonych. Zadanie nocne kopiujące plik CSV to potok. System strumieniowy przetwarzający miliony zdarzeń na sekundę to również potok. Narzędzia są różne: Airflow, Dagster, Prefect do orkiestracji. Kafka, Kinesis i Pub/Sub do strumieniowania. DBT do transformacji. Wyzwania są spójne. Źródła zmieniają się bez ostrzeżenia. Dane docierają z opóźnieniem lub są niepoprawne. Zadania kończą się niepowodzeniem o 2 w nocy i nikt tego nie zauważa, dopóki poranny raport nie jest pusty. Dobre potoki danych mają monitorowanie, alerty, logikę ponawiania prób i idempotentne kroki, które mogą zostać uruchomione dwukrotnie bez duplikowania danych. Są udokumentowane, aby każdy mógł zrozumieć ich działanie. Są testowane, aby zmiany nie zakłóciły działania systemów niższego rzędu. Potok danych to infrastruktura. Jak każda infrastruktura, działa najlepiej, gdy nikt nie musi o nim myśleć.
Etapy rurociągu
- Ekstrakt — pobieranie danych ze źródeł
- Przekształć — oczyść, wzbogac i nadaj nowy kształt
- Załaduj — zapisz do systemu docelowego
- Orkiestracja — planowanie i koordynacja kroków
- Monitoruj — wykrywaj awarie i wysyłaj alerty
Rurociąg danych to łańcuch dostaw danych. Jeśli ulegnie awarii, wszystko, co znajduje się niżej, przestaje działać.
Comments
No comments yet. Be the first to share a thought.
Leave a comment