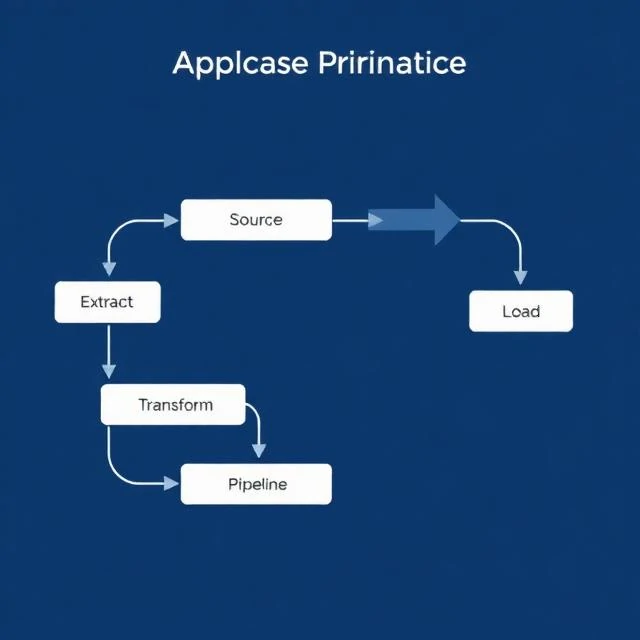
Um pipeline de dados move os dados da origem para o destino através de uma série de passos: Extração da origem; Transformação para se adequar ao destino; Carregamento no armazenamento; e Disponibilização para análise. O pipeline é executado automaticamente, de acordo com um cronograma ou em resposta a eventos. Cuida da infraestrutura para que os analistas e cientistas de dados se possam concentrar na utilização dos dados, em vez de os mover.
Os pipelines variam de simples a complexos. Uma tarefa noturna que copia um ficheiro CSV é um pipeline. Um sistema de streaming que processa milhões de eventos por segundo é também um pipeline. As ferramentas variam: Airflow, Dagster, Prefect para orquestração; Kafka, Kinesis e Pub/Sub para streaming; dbt para transformação. Os desafios são consistentes. As fontes mudam sem aviso prévio. Os dados chegam atrasados ou malformados. As tarefas falham às 2 da manhã e ninguém dá por isso até que o relatório da manhã esteja vazio. Os bons pipelines possuem monitorização, alertas, lógica de repetição e passos idempotentes que podem ser executados duas vezes sem duplicar dados. Estão documentados para que qualquer pessoa possa compreender o que fazem. São testados para que as alterações não quebrem os sistemas subsequentes. Um pipeline é infraestrutura. Como qualquer infraestrutura, funciona melhor quando ninguém tem de se preocupar com ele.
Etapas do pipeline
- Extrair — obter dados de fontes
- Transformar — limpar, enriquecer e remodelar
- Carregar — escrever no sistema de destino
- Orquestrar — agendar e coordenar etapas
- Monitorizar — detetar e alertar sobre falhas
Um pipeline de dados é uma cadeia de fornecimento para dados. Se falhar, tudo o que está a jusante pára.
Comments
No comments yet. Be the first to share a thought.
Leave a comment