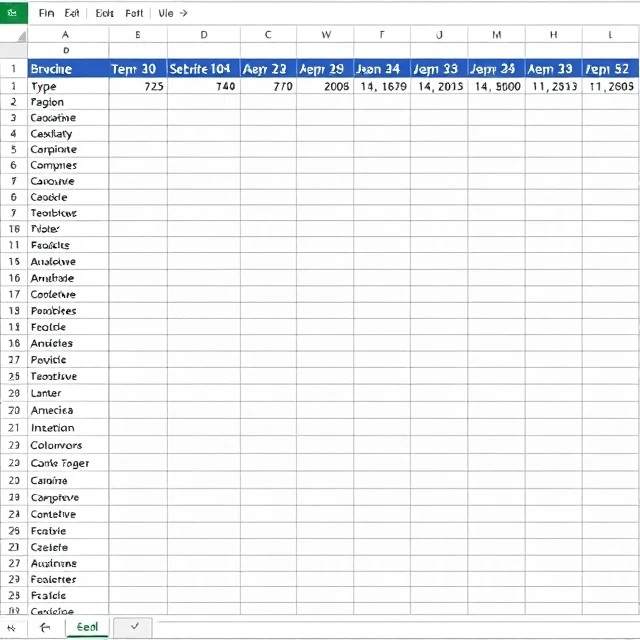
構造化データは、行と列にきれいに収まります。名前、日付、金額、カテゴリなどです。各フィールドには定義された型があり、各レコードは同じ形式に従います。構造はスキーマによって事前に定義されます。リレーショナルデータベース、スプレッドシート、CSVファイルなど、あらゆる媒体で構造化データが格納されます。重要なのは、その厳格さです。構造が予測可能であるため、クエリは高速で、結果も一貫しています。テーブルの結合、値の集計、行のフィルタリングなどを、データが期待どおりに動作することを確信して行うことができます。
構造化データは、従来のビジネスシステムで主流となっています。取引、在庫、顧客記録、財務台帳はすべて構造化されています。スキーマによって一貫性が強制されます。日付フィールドにはテキストを含めることはできません。数値フィールドには文字列を含めることはできません。この強制により、エラーを早期に検出できます。また、データの分析も容易になります。SQLは構造化データ用に構築されています。ビジネスインテリジェンスツールはそれを前提としています。機械学習モデルはしばしばそれを好みます。制限は柔軟性です。構造化データでは、データを保存する前にスキーマを知っておく必要があります。データの構造が変わると、スキーマも変更する必要があります。この移行は混乱を招きます。半構造化データと非構造化データは、構造をクエリ時に延期することでこの問題を回避します。しかし、柔軟性と引き換えに複雑になります。構造化データは扱いやすく、変更しにくいです。ほとんどの組織は構造化データで運用されています。会計システム、CRM、ERPなど、すべて構造化データを格納しています。刺激的ではありませんが、基盤となっています。
構造化データの特性
- スキーマ定義 — 構造が事前にわかっている
- 表形式 — 行と列
- 型付き — 各フィールドにはデータ型があります
- クエリ可能 — SQLおよび類似の言語
- 一貫性 – すべてのレコードで同じ形式
構造化データは予測可能である。その予測可能性こそが、構造化データを有用なものにすると同時に、柔軟性を欠くものにしている。
Comments
No comments yet. Be the first to share a thought.
Leave a comment