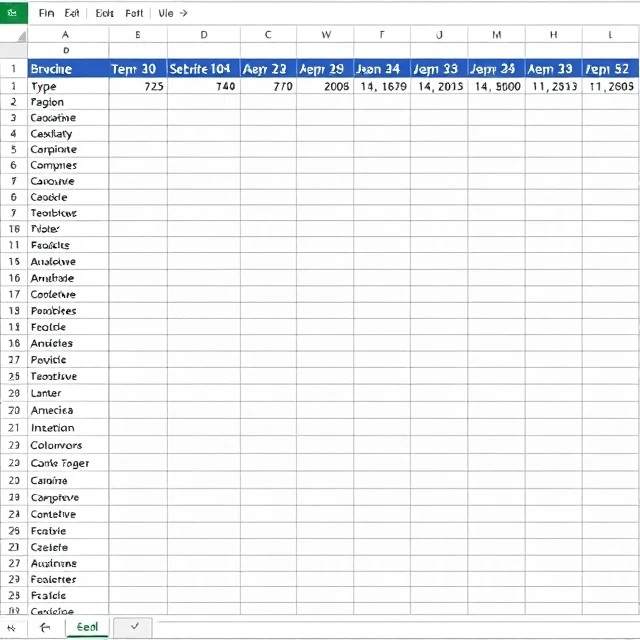
Strukturerte data passer fint inn i rader og kolonner. Navn, datoer, beløp og kategorier. Hvert felt har en definert type. Hver post følger samme format. Strukturen er definert på forhånd av et skjema. Relasjonsdatabaser lagrer strukturerte data. Regneark lagrer dem. CSV-filer lagrer dem. Poenget er stivheten. Fordi strukturen er forutsigbar, er spørringene raske og resultatene konsistente. Du kan slå sammen tabeller, aggregere verdier og filtrere rader med trygghet om at dataene vil oppføre seg som forventet.
Strukturerte data dominerer tradisjonelle forretningssystemer. Transaksjoner, varelager, kunderegistre og økonomiske regnskapsbøker er alle strukturerte. Skjemaet håndhever konsistens. Et datofelt kan ikke inneholde tekst. Et numerisk felt kan ikke inneholde en streng. Denne håndhevingen fanger opp feil tidlig. Det gjør også dataene enkle å analysere. SQL ble bygget for strukturerte data. Business intelligence-verktøy forutsetter det. Maskinlæringsmodeller foretrekker det ofte. Begrensningen er fleksibilitet. Strukturerte data krever at man kjenner skjemaet før man lagrer dataene. Hvis dataene endrer form, må du endre skjemaet. Den migreringen er forstyrrende. Semistrukturerte og ustrukturerte data unngår dette problemet ved å utsette strukturen til spørretid. Men de bytter fleksibilitet mot kompleksitet. Strukturerte data er enklere å jobbe med og vanskeligere å endre. De fleste organisasjoner kjører på det. Regnskapssystemet, CRM-systemet, ERP-systemet. De lagrer alle strukturerte data. Det er ikke spennende. Det er grunnlaget.
Strukturerte dataegenskaper
- Skjemadefinert — struktur kjent på forhånd
- Tabellform – rader og kolonner
- Typet – hvert felt har en datatype
- Spørbar — SQL og lignende språk
- Konsekvent – samme format for hver post
Strukturerte data er forutsigbare. Denne forutsigbarheten er det som gjør dem nyttige og det som gjør dem rigide.
Comments
No comments yet. Be the first to share a thought.
Leave a comment