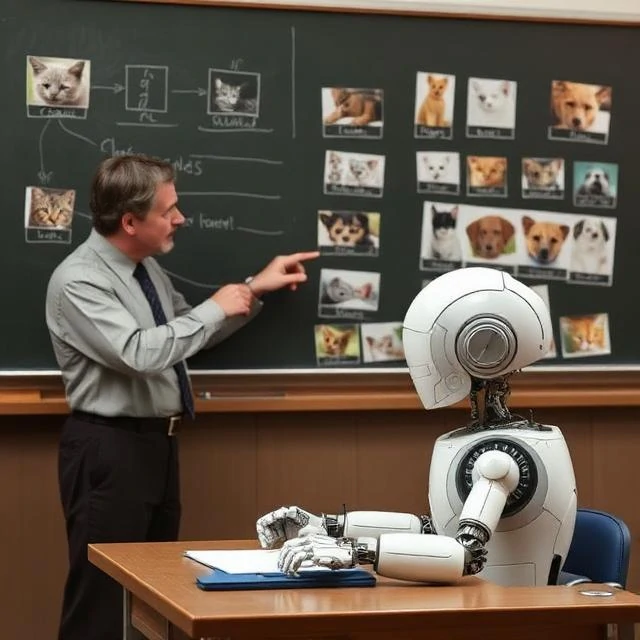
Um filtro de spam marca um e-mail como lixo eletrónico porque já analisou milhares de mensagens classificadas como "spam" ou "não spam". Isto é aprendizagem supervisionada em miniatura: um modelo aprende um mapeamento de entradas para saídas usando exemplos em que a resposta correta é conhecida. Cada par de treino tem um rótulo, e o algoritmo ajusta os seus parâmetros internos até que as suas previsões correspondam a esses rótulos com precisão suficiente para generalizar para novos dados.
A abordagem divide-se em duas grandes famílias. A classificação prevê uma categoria, como por exemplo se um tumor é benigno ou maligno. A regressão prevê um número, como a temperatura de amanhã ou o preço de uma casa. Ambas se baseiam no mesmo ciclo central: fazer uma previsão, medir o erro em relação ao rótulo e ajustar os pesos para reduzir esse erro.
Algoritmos comuns
- Regressão linear e logística para linhas de base simples e interpretáveis.
- Árvores de decisão e florestas aleatórias para dados tabulares
- Máquinas de vetores de suporte para classificação baseada em margens
- Redes neuronais para imagens, fala e linguagem
A rotulagem custa tempo e dinheiro. Um radiologista que anote 10.000 exames é caro; uma equipa de trabalhadores a rotular sentimentos é lenta e ruidosa. Este custo é a principal razão pela qual os métodos não supervisionados e semissupervisionados atraem tanta atenção. No entanto, quando há abundância de rótulos limpos, a aprendizagem supervisionada continua a ser a ferramenta mais fiável.
Comments
No comments yet. Be the first to share a thought.
Leave a comment