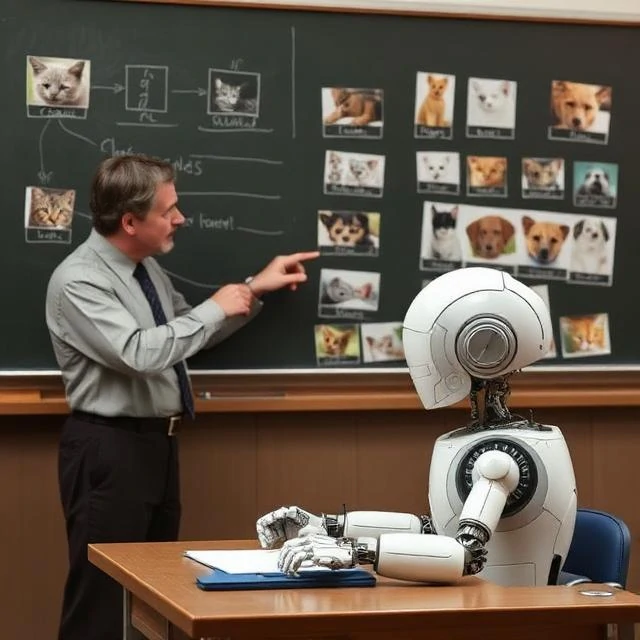
スパムフィルターは、すでに何千もの「スパム」または「スパムではない」と判定されたメールを検知しているため、あるメールを迷惑メールとしてフラグ付けします。これは、教師あり学習のミニチュア版と言えるでしょう。モデルは、正解が既知の例を用いて、入力から出力へのマッピングを学習します。各トレーニングペアにはラベルが付与され、アルゴリズムは予測が新しいデータにも適用できるほどラベルに近づくまで、内部パラメータを調整します。
このアプローチは大きく2つの系統に分けられます。分類は、腫瘍が良性か悪性かといったカテゴリを予測します。回帰は、明日の気温や住宅価格といった数値を予測します。どちらも、予測を行い、ラベルとの誤差を測定し、誤差を減らすように重みを調整するという、同じ基本的なループに基づいています。
一般的なアルゴリズム
- 単純で解釈しやすいベースラインのための線形回帰とロジスティック回帰
- 表形式データのための決定木とランダムフォレスト
- マージンベース分類のためのサポートベクターマシン
- 画像、音声、言語のためのニューラルネットワーク
ラベル付けには費用と時間がかかります。1万枚の画像に注釈を付ける放射線科医は高額ですし、感情ラベルを付ける作業員の集団は時間がかかり、ノイズも発生します。こうしたコストこそが、教師なし学習や半教師あり学習が注目を集める主な理由です。しかし、質の高いラベルが豊富に存在する場合には、教師あり学習が最も信頼できるツールであることに変わりはありません。
Comments
No comments yet. Be the first to share a thought.
Leave a comment