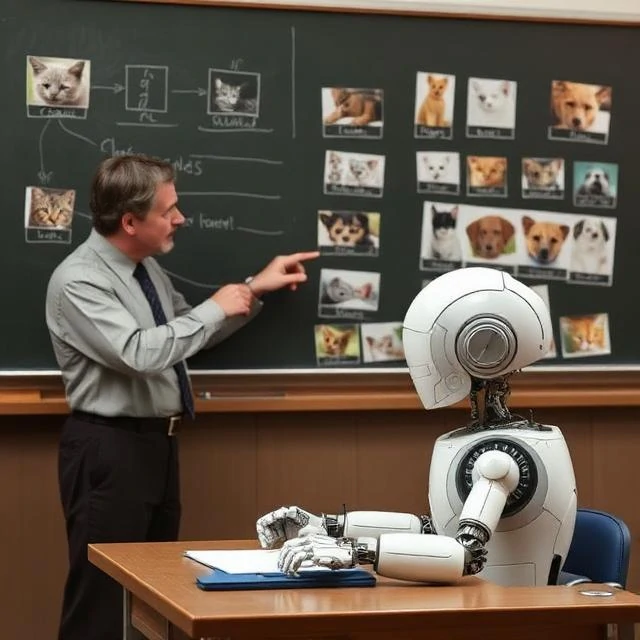
垃圾郵件過濾器之所以會將郵件標記為垃圾郵件,是因為它已經識別出成千上萬封被標記為「垃圾郵件」或「非垃圾郵件」的郵件。這其實就是監督學習的簡化版:模型透過學習已知正確答案的範例,來建立輸入到輸出的映射關係。每個訓練樣本對都帶有一個標籤,演算法會不斷調整其內部參數,直到預測結果與這些標籤足夠匹配,從而能夠推廣到新的資料。
此方法分為兩大類。分類預測類別,例如腫瘤是良性還是惡性。迴歸預測數值,例如明天的溫度或房價。兩者都依賴相同的核心循環:做出預測,衡量預測結果與標籤的誤差,並調整權重以減少誤差。
常用演算法
- 用於簡單、易於解釋的基線的線性迴歸和邏輯迴歸
- 決策樹和隨機森林在表格資料中的應用
- 支援向量機用於基於間隔的分類
- 用於影像、語音和語言的神經網絡
標籤標註需要耗費金錢和時間。一位放射科醫生標註一萬張掃描影像的費用很高;一群工作人員進行情感標註既緩慢又容易出錯。正是由於這種高昂的成本,無監督和半監督方法才如此引人注目。然而,當有大量乾淨的標籤時,監督學習仍然是最可靠的工具。
Comments
No comments yet. Be the first to share a thought.
Leave a comment