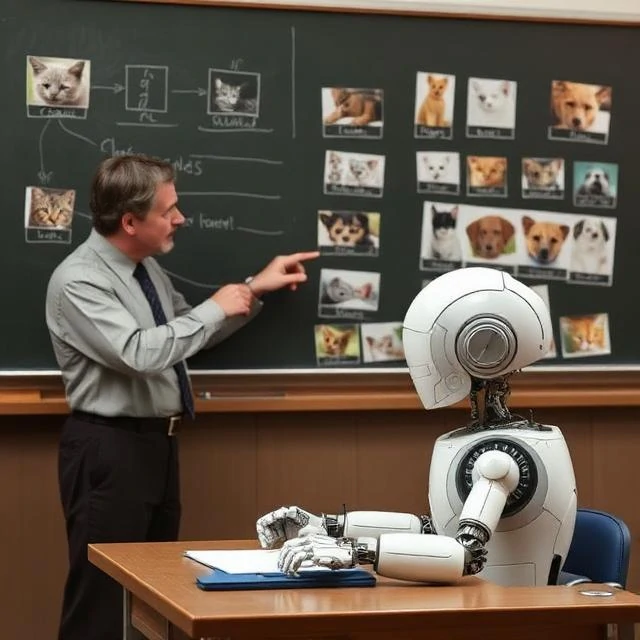
스팸 필터는 이미 수천 개의 메시지가 "스팸" 또는 "스팸 아님"으로 표시된 것을 확인했기 때문에 해당 이메일을 스팸으로 분류합니다. 이는 지도 학습의 축소판이라고 할 수 있습니다. 모델은 정답이 알려진 예제를 사용하여 입력과 출력 간의 매핑을 학습합니다. 각 학습 데이터 쌍에는 레이블이 지정되어 있으며, 알고리즘은 예측 결과가 새로운 데이터에 일반화될 수 있을 만큼 레이블과 일치할 때까지 내부 매개변수를 조정합니다.
이 접근 방식은 크게 두 가지 유형으로 나뉩니다. 분류는 종양이 양성인지 악성인지와 같은 범주를 예측합니다. 회귀는 내일의 기온이나 집값과 같은 수치를 예측합니다. 두 방식 모두 동일한 핵심 과정을 따릅니다. 즉, 예측을 하고, 레이블과의 오차를 측정하고, 오차를 줄이기 위해 가중치를 조정합니다.
일반적인 알고리즘
- 단순하고 해석 가능한 기준선을 위한 선형 및 로지스틱 회귀 분석
- 표 형식 데이터에 대한 의사 결정 트리 및 랜덤 포레스트
- 마진 기반 분류를 위한 서포트 벡터 머신
- 이미지, 음성 및 언어 처리를 위한 신경망
라벨링에는 비용과 시간이 소요됩니다. 1만 개의 스캔 이미지에 주석을 다는 방사선 전문의는 비용이 많이 들고, 감정 라벨링 작업을 하는 다수의 작업자는 속도가 느리고 오류가 발생하기 쉽습니다. 이러한 비용 때문에 비지도 학습 및 준지도 학습 방식이 많은 주목을 받고 있습니다. 하지만 깨끗한 라벨이 풍부하게 존재하는 경우에는 지도 학습이 여전히 가장 신뢰할 수 있는 도구입니다.
Comments
No comments yet. Be the first to share a thought.
Leave a comment