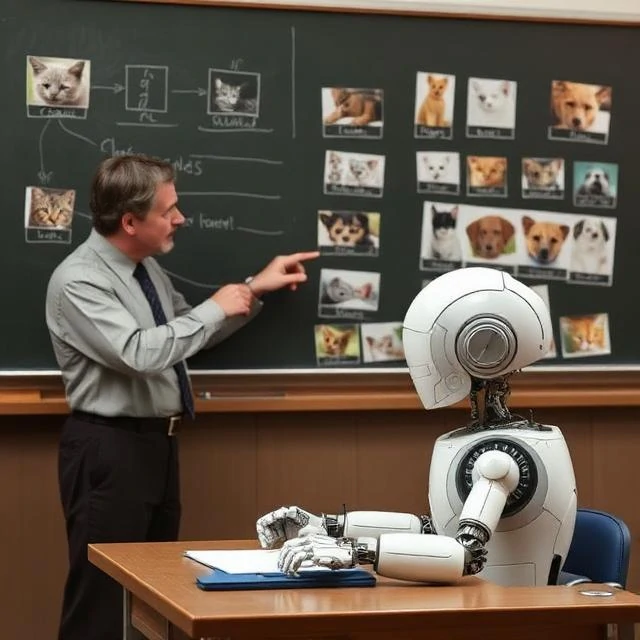
垃圾邮件过滤器之所以会将邮件标记为垃圾邮件,是因为它已经识别出成千上万封被标记为“垃圾邮件”或“非垃圾邮件”的邮件。这其实就是监督学习的简化版:模型通过学习已知正确答案的示例,来建立输入到输出的映射关系。每个训练样本对都带有一个标签,算法会不断调整其内部参数,直到预测结果与这些标签足够匹配,从而能够推广到新的数据。
该方法分为两大类。分类预测类别,例如肿瘤是良性还是恶性。回归预测数值,例如明天的温度或房价。两者都依赖于相同的核心循环:做出预测,衡量预测结果与标签的误差,并调整权重以减少误差。
常用算法
- 用于简单、易于解释的基线的线性回归和逻辑回归
- 决策树和随机森林在表格数据中的应用
- 支持向量机用于基于间隔的分类
- 用于图像、语音和语言的神经网络
标签标注需要耗费金钱和时间。一位放射科医生标注一万张扫描图像的费用很高;一群工作人员进行情感标注既缓慢又容易出错。正是由于这种高昂的成本,无监督和半监督方法才如此引人注目。然而,当存在大量干净的标签时,监督学习仍然是最可靠的工具。
Comments
No comments yet. Be the first to share a thought.
Leave a comment