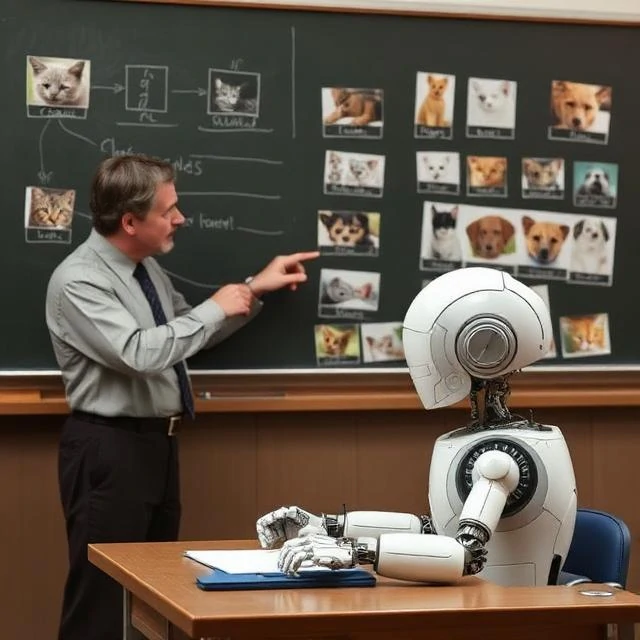
Egy spamszűrő azért jelöl meg egy e-mailt levélszemétként, mert több ezer, „spam” vagy „nem spam” megjelölésű üzenetet látott. Ez miniatűr felügyelt tanulás: egy modell a bemenetek és kimenetek közötti megfeleltetést tanulja meg olyan példák felhasználásával, ahol ismert a helyes válasz. Minden betanítási pár egy címkét tartalmaz, és az algoritmus addig módosítja a belső paramétereit, amíg az előrejelzései elég szorosan illeszkednek ezekhez a címkékhez ahhoz, hogy új adatokra általánosíthatók legyenek.
A megközelítés két nagy családra oszlik. Az osztályozás egy kategóriát jósol meg, például azt, hogy egy daganat jóindulatú vagy rosszindulatú-e. A regresszió egy számot jósol meg, például a holnapi hőmérsékletet vagy egy házárat. Mindkettő ugyanarra az alapvető ciklusra épül: előrejelzést készít, a hibát a címkéhez viszonyítja, és a súlyok módosításával csökkenti a hibát.
Gyakori algoritmusok
- Lineáris és logisztikus regresszió egyszerű, értelmezhető alapvonalakhoz
- Döntési fák és véletlenszerű erdők táblázatos adatokhoz
- Támogató vektor gépek margó alapú osztályozáshoz
- Neurális hálózatok képekhez, beszédhez és nyelvhez
A címkék pénzbe és időbe kerülnek. Egy radiológus, aki 10 000 felvételt annotál, drága; egy csapatnyi, a véleményeket címkéző munkatárs lassú és zajos. Ez a költség a fő oka annak, hogy a felügyelet nélküli és félig felügyelt módszerek miért vonzzák a figyelmet. Amikor azonban bőségesen léteznek letisztult címkék, a felügyelt tanulás továbbra is a legmegbízhatóbb eszköz.
Comments
No comments yet. Be the first to share a thought.
Leave a comment