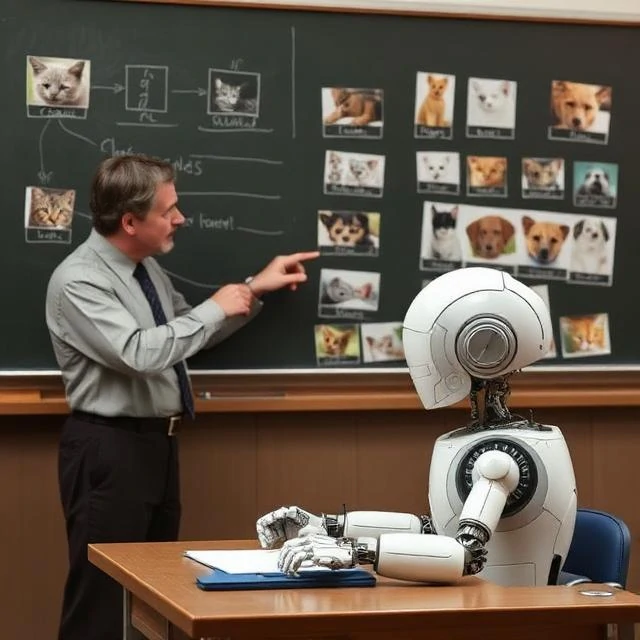
Spamový filtr označí e-mail jako nevyžádanou poštu, protože již viděl tisíce zpráv označených jako „spam“ nebo „není spam“. To je miniaturní řízené učení: model se učí mapování vstupů na výstupy pomocí příkladů, kde je známa správná odpověď. Každá trénovací dvojice nese označení a algoritmus upravuje své interní parametry, dokud se jeho předpovědi s těmito označeními dostatečně neodpovídají, aby je bylo možné zobecnit na nová data.
Tento přístup se dělí do dvou širokých skupin. Klasifikace predikuje kategorii, například zda je nádor benigní nebo maligní. Regrese predikuje číslo, například zítřejší teplotu nebo cenu domu. Oba se spoléhají na stejnou základní smyčku: vytvoření predikce, porovnání chyby s popiskem a úprava vah pro snížení této chyby.
Běžné algoritmy
- Lineární a logistická regrese pro jednoduché a interpretovatelné základní linie
- Rozhodovací stromy a náhodné lesy pro tabulková data
- Stroje support vector pro klasifikaci založenou na maržích
- Neuronové sítě pro obrazy, řeč a jazyk
Označování stojí peníze a čas. Radiolog, který anotuje 10 000 skenů, je drahý; dav pracovníků, kteří označují sentiment, je pomalý a hlučný. Tyto náklady jsou hlavním důvodem, proč metody bez dozoru a částečně dozoru přitahují tolik pozornosti. Pokud však existuje hojnost čistých označení, zůstává učení s dozorem nejspolehlivějším nástrojem.
Comments
No comments yet. Be the first to share a thought.
Leave a comment