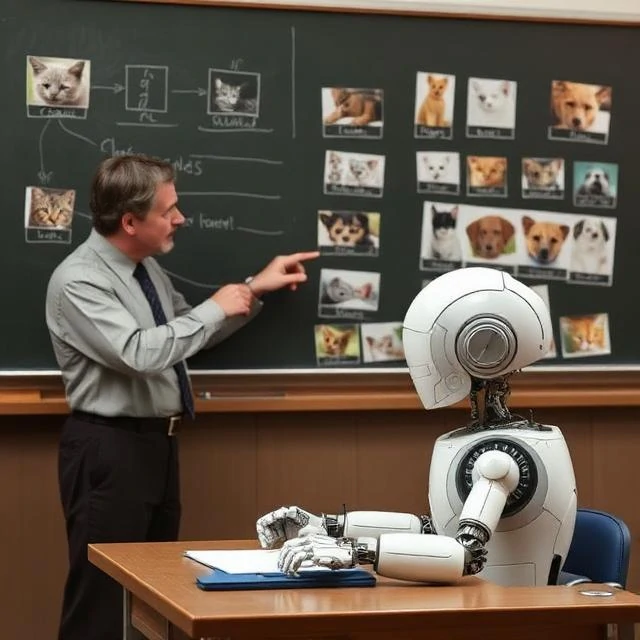
स्पैम फ़िल्टर किसी ईमेल को जंक के रूप में चिह्नित करता है क्योंकि उसने पहले से ही हजारों संदेशों को "स्पैम" या "नॉन-स्पैम" के रूप में चिह्नित होते देखा है। यही सुपरवाइज्ड लर्निंग का एक छोटा रूप है: एक मॉडल ऐसे उदाहरणों का उपयोग करके इनपुट से आउटपुट तक की मैपिंग सीखता है जहां सही उत्तर ज्ञात होता है। प्रत्येक ट्रेनिंग पेयर में एक लेबल होता है, और एल्गोरिदम अपने आंतरिक मापदंडों को तब तक समायोजित करता है जब तक कि उसकी भविष्यवाणियां उन लेबलों से इतनी सटीक रूप से मेल न खा जाएं कि उन्हें नए डेटा पर लागू किया जा सके।
इस पद्धति को दो मुख्य श्रेणियों में बांटा जा सकता है। वर्गीकरण किसी श्रेणी का पूर्वानुमान लगाता है, जैसे कि ट्यूमर सौम्य है या घातक। प्रतिगमन किसी संख्या का पूर्वानुमान लगाता है, जैसे कि कल का तापमान या घर की कीमत। दोनों पद्धतियां एक ही मूल प्रक्रिया पर आधारित हैं: पूर्वानुमान लगाना, श्रेणी के सापेक्ष त्रुटि का मापन करना और त्रुटि को कम करने के लिए भार को समायोजित करना।
सामान्य एल्गोरिदम
- सरल, व्याख्या योग्य आधार रेखाओं के लिए रैखिक और लॉजिस्टिक प्रतिगमन
- सारणीबद्ध डेटा के लिए निर्णय वृक्ष और यादृच्छिक वन
- मार्जिन-आधारित वर्गीकरण के लिए सपोर्ट वेक्टर मशीनें
- छवियों, भाषण और भाषा के लिए तंत्रिका नेटवर्क
लेबल लगाने में पैसा और समय दोनों लगते हैं। 10,000 स्कैन पर टिप्पणी करने वाला रेडियोलॉजिस्ट महंगा पड़ता है; वहीं कई कर्मचारियों द्वारा भावों को लेबल करना धीमा और शोरगुल भरा काम होता है। यही खर्च अनियंत्रित और अर्ध-नियंत्रित विधियों को इतना अधिक महत्व मिलने का मुख्य कारण है। हालांकि, जब स्पष्ट लेबल प्रचुर मात्रा में उपलब्ध होते हैं, तो पर्यवेक्षित शिक्षण सबसे विश्वसनीय उपकरण बना रहता है।
Comments
No comments yet. Be the first to share a thought.
Leave a comment