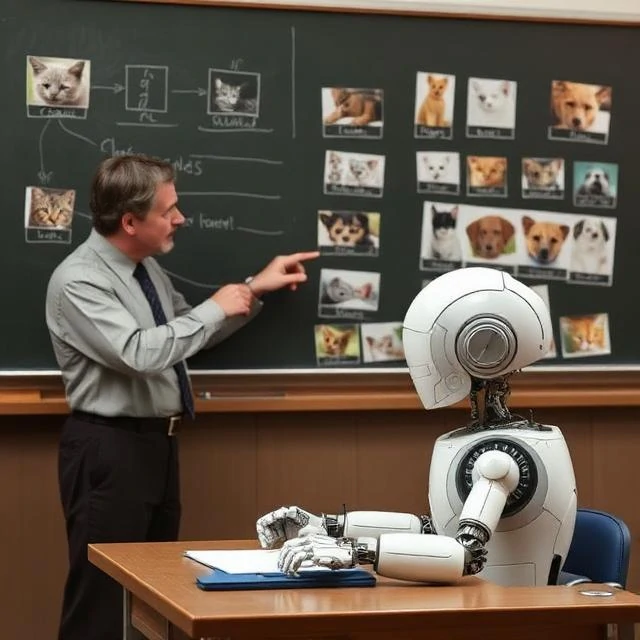
Un filtro de spam marca un correo electrónico como basura porque ya ha visto miles de mensajes marcados como "spam" o "no spam". Esto es aprendizaje supervisado en miniatura: un modelo aprende una correspondencia entre entradas y salidas utilizando ejemplos donde se conoce la respuesta correcta. Cada par de entrenamiento lleva una etiqueta, y el algoritmo ajusta sus parámetros internos hasta que sus predicciones coinciden lo suficiente con esas etiquetas como para generalizar a nuevos datos.
Este enfoque se divide en dos grandes familias. La clasificación predice una categoría, como si un tumor es benigno o maligno. La regresión predice un valor numérico, como la temperatura de mañana o el precio de una vivienda. Ambas se basan en el mismo ciclo fundamental: realizar una predicción, medir el error con respecto a la etiqueta y ajustar los pesos para reducir dicho error.
Algoritmos comunes
- Regresión lineal y logística para líneas base simples e interpretables.
- Árboles de decisión y bosques aleatorios para datos tabulares
- Máquinas de vectores de soporte para clasificación basada en márgenes
- Redes neuronales para imágenes, voz y lenguaje.
Las etiquetas cuestan dinero y tiempo. Un radiólogo que anota 10 000 exploraciones es caro; un grupo de trabajadores etiquetando el sentimiento es lento y ruidoso. Ese coste es la principal razón por la que los métodos no supervisados y semisupervisados atraen tanta atención. Sin embargo, cuando existen etiquetas claras en abundancia, el aprendizaje supervisado sigue siendo la herramienta más fiable.
Comments
No comments yet. Be the first to share a thought.
Leave a comment