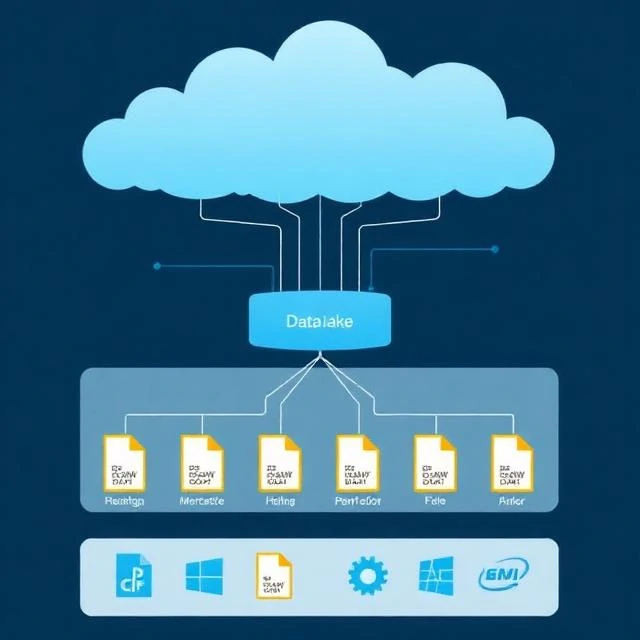
データレイクは、生データをネイティブ形式で保存します。書き込み時にスキーマは適用されません。構造化テーブル、JSONログ、画像、動画など、あらゆるデータが同じリポジトリに格納されます。スキーマはデータの読み込み時に適用され、保存時には適用されません。この柔軟性が魅力です。データレイクはあらゆるデータを受け入れます。データを保存する前に、そのデータをどのように利用するかを把握する必要はありません。
柔軟性もまた問題です。ガバナンスがなければ、データレイクはデータの沼と化してしまいます。誰もその中身を把握できず、ファイル名は意味不明で、メタデータも欠落し、データは複数のフォルダに重複して保存されます。アナリストは必要なデータを見つけることができません。データサイエンティストは分析ではなく、データのクリーンアップや探索に時間を費やしてしまいます。レイクは資産ではなく、コストセンターと化してしまうのです。解決策はガバナンスです。カタログ、メタデータ、アクセス制御、そして明確な所有権を確立することが重要です。最新のデータレイクハウスアーキテクチャでは、Delta LakeやIcebergといったテーブルフォーマットが追加され、スキーマの強制、ACIDトランザクション、クエリパフォーマンスがレイクにもたらされます。レイクとウェアハウスが融合し、生のストレージの柔軟性と構造化テーブルの信頼性という、両方の長所を兼ね備えるのです。テクノロジーは進化しましたが、ガバナンスの必要性は依然として変わりません。
データレイクの特性
- スキーマオンリード — クエリ時に構造を適用する
- 生データストレージ - 元の形式で保存されたデータ
- 拡張性あり ― 汎用ストレージでペタバイト規模のデータを処理可能
- 柔軟性 – 構造化データ、半構造化データ、非構造化データをサポートする
- ガバナンスに依存する――カタログ化がなければ、それは沼地と化す。
データレイクは貯水池のようなものだ。地図がなければ、それはただの水域に過ぎない。
Comments
No comments yet. Be the first to share a thought.
Leave a comment