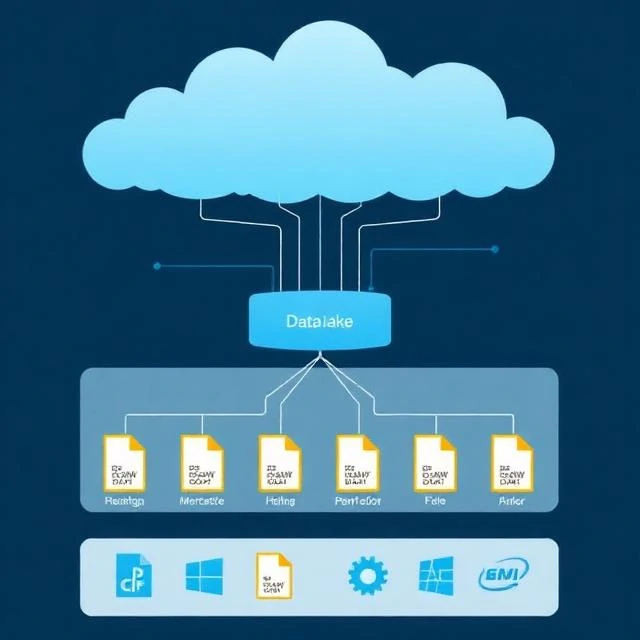
Озеро данных хранит необработанные данные в их исходном формате. При записи схема не применяется. Структурированные таблицы, JSON-логи, изображения и видео — все это хранится в одном репозитории. Схема применяется при чтении данных, а не при их сохранении. Именно эта гибкость и является его привлекательностью. Озеро данных принимает любые данные. Вам не нужно знать, как вы будете использовать данные, прежде чем их сохранять.
Проблема заключается и в гибкости. Без управления хранилище данных превращается в болото. Никто не знает, что в нём находится. Файлы имеют непонятные имена. Метаданные отсутствуют. Данные дублируются в разных папках. Аналитики не могут найти то, что им нужно. Специалисты по анализу данных тратят время на очистку и исследование, вместо того чтобы анализировать. Озеро становится центром затрат, а не активом. Решение — управление: каталоги, метаданные, контроль доступа и чёткое определение владельца. Современные архитектуры хранилищ данных добавляют форматы таблиц, такие как Delta Lake и Iceberg, которые обеспечивают соблюдение схемы, ACID-транзакции и повышение производительности запросов. Озеро и хранилище данных сходятся. Лучшее из обоих миров: гибкость необработанного хранилища и надёжность структурированных таблиц. Технология улучшилась. Требование к управлению остаётся.
Характеристики озера данных
- Schema-on-read — применение структуры при выполнении запроса.
- Хранение исходных данных — данные, сохраненные в исходном формате.
- Масштабируемый — обрабатывает петабайты данных на стандартных накопителях.
- Гибкий — поддерживает структурированные, полуструктурированные и неструктурированные данные.
- Зависимость от управления — без каталогизации превращается в болото.
Озеро данных — это резервуар. Без карты это просто водоём.
Comments
No comments yet. Be the first to share a thought.
Leave a comment