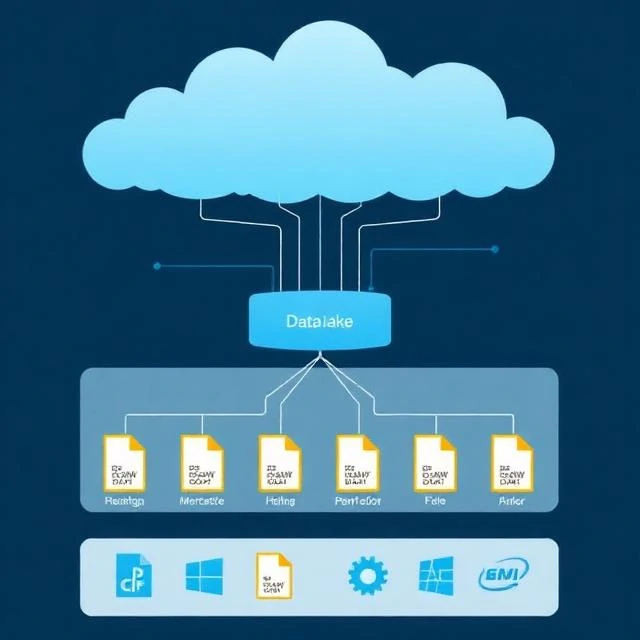
Ein Data Lake speichert Rohdaten in ihrem nativen Format. Beim Schreiben wird kein Schema erzwungen. Strukturierte Tabellen, JSON-Logs, Bilder und Videos befinden sich alle im selben Repository. Das Schema wird erst beim Lesen der Daten angewendet, nicht beim Speichern. Diese Flexibilität ist sein größter Vorteil. Der Data Lake akzeptiert beliebige Datentypen. Sie müssen nicht wissen, wie Sie die Daten verwenden werden, bevor Sie sie speichern.
Die Flexibilität ist gleichzeitig das Problem. Ohne Governance wird ein Data Lake zum Datensumpf. Niemand weiß, was sich darin befindet. Dateien haben kryptische Namen. Metadaten fehlen. Die Daten sind in verschiedenen Ordnern dupliziert. Analysten finden nicht, was sie benötigen. Data Scientists verschwenden Zeit mit Bereinigen und Erkunden, anstatt zu analysieren. Der Lake wird zum Kostenfaktor, nicht zum Asset. Die Lösung ist Governance: Kataloge, Metadaten, Zugriffskontrollen und klare Verantwortlichkeiten. Moderne Data-Lake-Architekturen ergänzen Tabellenformate wie Delta Lake und Iceberg, die Schema-Durchsetzung, ACID-Transaktionen und Abfrageleistung für den Lake ermöglichen. Lake und Data Warehouse verschmelzen. Das Beste aus beiden Welten: die Flexibilität von Rohdatenspeichern und die Zuverlässigkeit strukturierter Tabellen. Die Technologie hat sich verbessert. Die Notwendigkeit von Governance bleibt bestehen.
Merkmale eines Datensees
- Schema-on-read — Struktur beim Abfragen anwenden
- Rohdatenspeicherung – Daten im Originalformat gespeichert
- Skalierbar – verarbeitet Petabytes auf Standardspeichern
- Flexibel – unterstützt strukturierte, semistrukturierte und unstrukturierte Daten
- Abhängig von der Verwaltung – ohne Katalogisierung wird es zu einem Sumpf.
Ein Data Lake ist wie ein Reservoir. Ohne eine Karte ist er nur ein Gewässer.
Comments
No comments yet. Be the first to share a thought.
Leave a comment